前向传播怎么算,这里当作已经知道了.要回答的是它后面那一步:拿到损失值之后,怎么知道每个参数该往哪调、调多少.
答案分三层:先是梯度本身(往哪调),再是自动微分怎么把它算出来(拓扑序那一套),最后是张量和工程优化(为什么真实框架里还得有人手写算子).
一、梯度:往哪调
一个能手工算完的网络
取最小的情形:两个输入,一个神经元,平方误差.
$$z = w_1x_1 + w_2x_2 + b, \qquad \hat y = \sigma(z), \qquad L = (\hat y – y)^2$$
对 $w_1$ 求偏导,链式法则把路径上每一段的局部导数乘起来:
$$\frac{\partial L}{\partial w_1} = \underbrace{2(\hat y – y)}_{\partial L/\partial \hat y}\cdot \underbrace{\sigma'(z)}_{\partial \hat y/\partial z}\cdot \underbrace{x_1}_{\partial z/\partial w_1}$$
三个参数都算出来,写成向量就是梯度:
$$\nabla_w L = 2(\hat y – y)\,\sigma'(z)\begin{bmatrix} x_1 \\ x_2 \end{bmatrix}$$
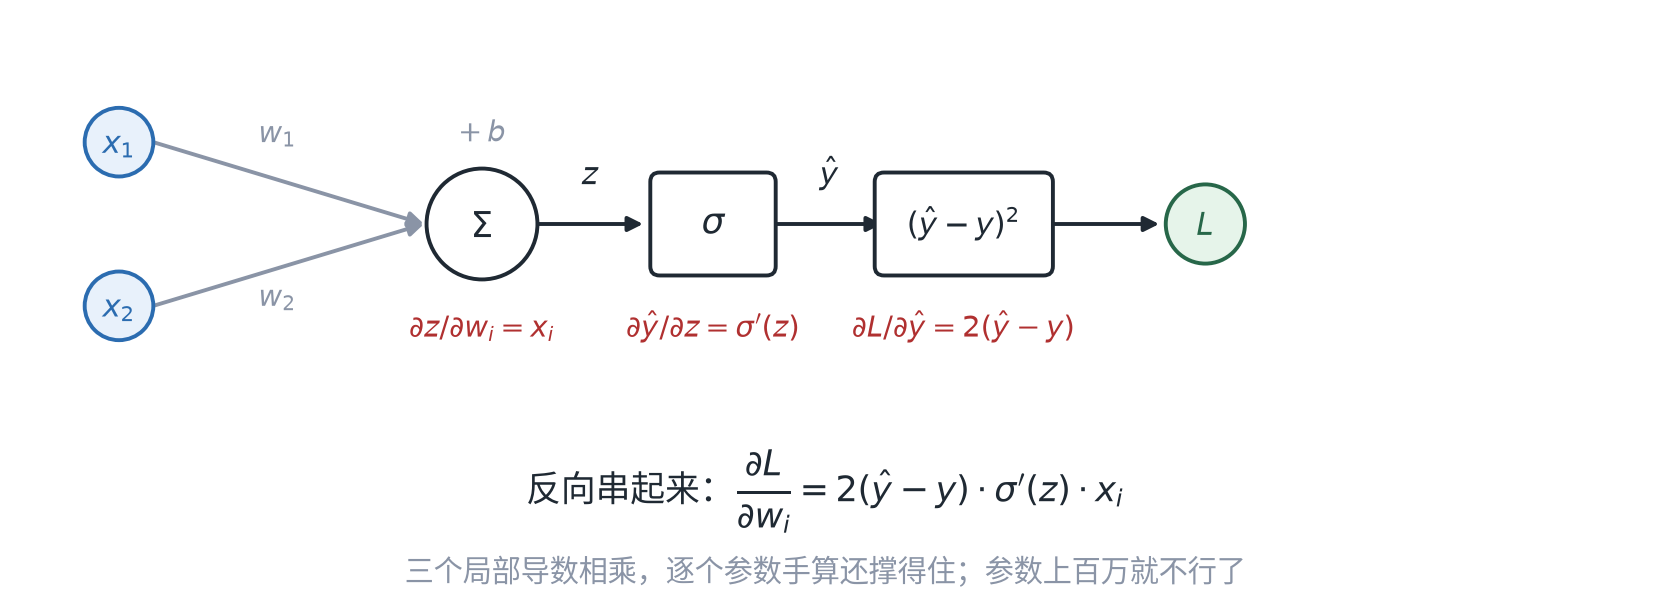
图 1:把链式法则拆成“每段一个局部导数,然后逐个相乘”.
为什么沿负梯度走一定下降
这不是显然的,但证明只有三行.
固定点 $x$,取一个方向 $v$.方向导数的定义是
$$D_vf(x)=\lim_{t\to0}\frac{f(x+tv)-f(x)}{t}$$
而“$f$ 在 $x$ 处可微”这句话本身就是说:$f$ 在 $x$ 附近可以被一个线性函数很好地逼近——
$$f(x+h)=f(x)+\nabla f(x)\cdot h+o(|h|)$$
代 $h=tv$ 进去,减掉 $f(x)$、除以 $t$:
$$\frac{f(x+tv)-f(x)}{t}=\nabla f(x)\cdot v+\frac{o(|t|)}{t}$$
最后一项在 $t\to0$ 时趋于 $0$.两边取极限:
$$D_vf(x)=\nabla f(x)\cdot v$$
整个推导只用了“可微”的定义,没欠任何别的定理.
这一步对任意 $v$ 都成立.下面的“最陡”才需要额外条件——要在同样步长下比较所有方向,就得把 $v$ 限制在单位球面上.
由 Cauchy–Schwarz,$|\nabla f \cdot v| \le |\nabla f|\,|v| = |\nabla f|$,且等号在 $v$ 与 $\nabla f$ 共线时取到.所以:
-
$v = \dfrac{\nabla f}{|\nabla f|}$ 时方向导数取最大值 $|\nabla f|$ ——梯度方向是上升最快的方向
-
$v = -\dfrac{\nabla f}{|\nabla f|}$ 时取最小值 $-|\nabla f|$ ——负梯度方向是下降最快的方向
“最快”这个词要落到实处:在同样步长的所有方向里,它让函数降得最多.图 2 里那个虚线圆就是这个意思——圆上每一点代表走同样远的一步.
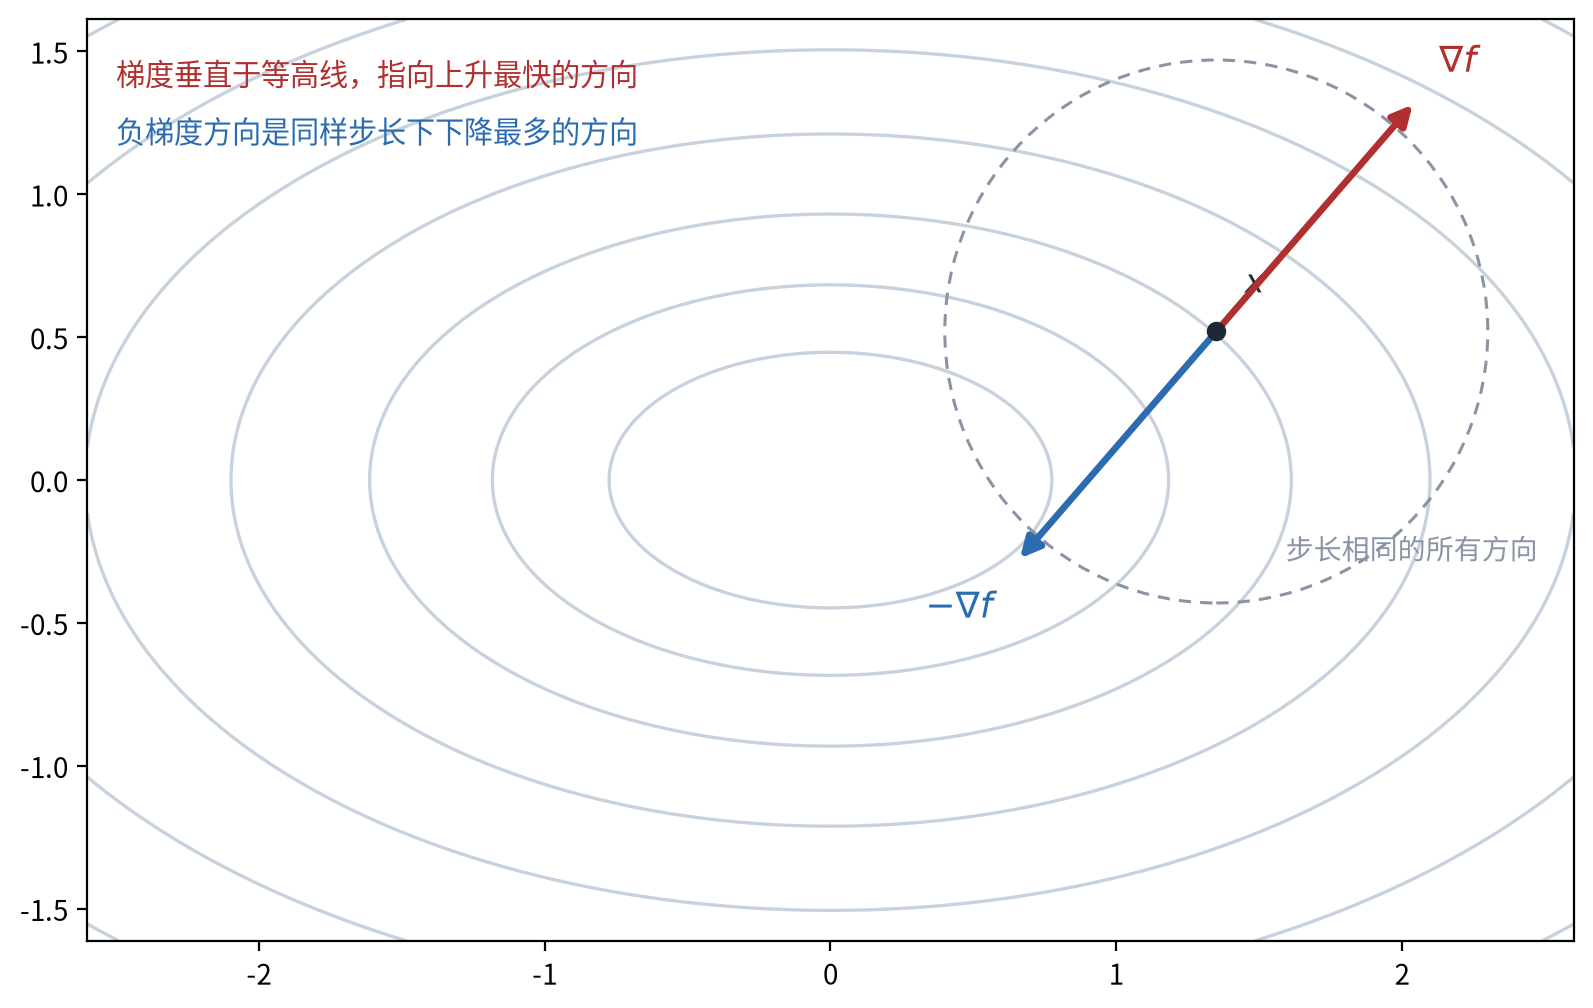
图 2:梯度垂直于等高线.虚线圆是等步长的所有方向,负梯度方向落在最低的等高线上.
再看它是不是真的会下降.一阶 Taylor:
$$f\!\left(x – t\frac{\nabla f}{|\nabla f|}\right) = f(x) – t|\nabla f| + o(t)$$
$t$ 足够小时,线性项 $-t|\nabla f|$ 压得住余项,函数值下降.这就是梯度下降
$$x \leftarrow x – \eta \nabla f(x)$$
三个必须说清楚的边界
上面这套推导有三个前提,工程里全部会踩到:
① 它是局部的、一阶的.当 $t$ 大到余项不再被线性项压住,下降的保证就失效了——步子迈大了反而上升.学习率要小、要衰减、要做线搜索,根源都在这里.
② “最陡”依赖于你怎么度量一步的长度.上面用的是 Euclidean 范数,所以得到 $\nabla f$.换一个范数——比如概率单纯形上的 KL 散度——“最陡方向”就变成别的东西.mirror descent 和自然梯度就是换度量换出来的.
③ $\nabla f = 0$ 只说明是驻点,不保证是极小值.局部极小、局部极大、鞍点都满足这个条件.高维空间里鞍点比局部极小常见得多得多.
二、计算图:从表达式到图
为什么要机械化
如果一个网络只有三个参数,链式法则手推还撑得住——把路径上每一段的局部导数乘起来就是了.
但真实网络有 $10^6$ 到 $10^9$ 个参数.而且注意:上面那条链是“对 $w_1$”推的.换一个参数,整条链要重推一遍.手算 $n$ 个偏导就是 $O(n)$ 的工作量.
数值微分更直白地说明了这件事有多贵:中心差分算一个偏导要两次前向,$n$ 个参数就要 $2n$ 次前向.
所以需要一台机器,把表达式变成一种可以机械地、一趟走完求导的数据结构.那个结构就是计算图.
计算图是什么
先把对象定义清楚,不然后面全在讲“怎么造一个还没定义的东西”.
一张计算图是一个有向无环图 $G=(V,E)$,并且:
-
每个顶点 $v$ 带一个标签:要么是叶子(一个已经给定的值),要么是算子 $f_v$(一个具体的函数:加法、乘法、$\sigma$……)
-
算子顶点还带一张有序入边表 $(u_1,\dots,u_k)$,表示 $f_v$ 的第 $i$ 个参数来自顶点 $u_i$
-
无环
它定义的是一个函数,不是一个值.给定每个叶子 $\ell$ 的取值 $c_\ell$,图上的值递归地算出来:
$$\mathrm{val}(v)= \begin{cases} c_v, & v \text{ 是叶子}\\[2pt] f_v\big(\mathrm{val}(u_1),\dots,\mathrm{val}(u_k)\big), & \text{否则} \end{cases}$$
无环保证这个递归有底、不会转圈.根节点的值就是整个表达式的值.
四件从这个定义直接读出来的事:
-
叶子是自变量,根是因变量.中间顶点是复合过程中的临时值.
-
求值必须按拓扑序.或者等价地,按上面那个递归展开——两者是同一件事的两种说法.
-
它是图,不是树.同一个顶点可以被多条边使用.第 13 步那个
d*d就是:如果把 $d$ 强行写成树,就得把它的整棵子树复制一份. -
为什么必须无环.有环意味着 $\mathrm{val}(v)$ 依赖自己,前向传播根本算不出来.
严格说,表达式树是计算图在“不允许任何顶点被共享”时的特例.共享一旦允许,树就长成了图.
两条路
给一个表达式,比如
$$L = \big(\sigma(w_1x_1 + w_2x_2 + b) – y\big)^2$$
想把它变成图,有两条路.
第一条:解析表达式文本.把字符串当源码,做词法分析和语法分析,得到抽象语法树,再翻译成图.这是编译器前端的做法.
第二条:拦截求值过程.不改表达式,只把参与运算的数换成一个“句柄”.每发生一次基本运算,就往图里追加一个节点,记下它用到的输入句柄.
主流 AD 系统走的都是第二条.理由很直接:表达式在执行之前,你不知道 if 会走哪个分支、循环转几圈、张量形状是多少.解析文本要求表达式是静态的;拦截求值不要求——只要表达式是执行出来的,就能被录下来.
代价是图只能在求值过程中建出来,所以每跑一次前向就得到一张新图.这个后果后面单独说.
三条规则
拦截求值的全部机制就三句话:
-
叶子建节点.每个变量、常数、输入数据,各建一个没有输入的节点.
-
基本运算建节点.每遇到一次基本运算,新建一个节点,把操作数的节点编号记进去.
-
图只增不改.新节点永远只引用已经存在的节点.
第 3 条不是可以商量的约定,它是整个机制能工作的前提——它保证了节点编号天然就是拓扑序(每个节点的输入编号都比它自己小).下一节会用到这个性质.
具体到 Python,一次乘法长这样:
class Node:
    _next_id = 0

    def __init__(self, val, op, inputs, backward):
        self.id = Node._next_id            # 编号只增,且只引用已有节点
        Node._next_id += 1
        self.val = val                     # 前向数值
        self.op = op                       # 算子,决定反向用哪条局部规则
        self.inputs = inputs               # 输入节点的编号
        self.grad = 0.0                    # 反向时在这里累加
        self._backward = backward          # 本算子自带的局部规则

    def __mul__(self, other):
        out = Node(self.val * other.val, "*", (self, other), None)

        def bw():                          # 局部规则:按另一个乘数分配上游梯度
            self.grad  += out.grad * other.val
            other.grad += out.grad * self.val

        out._backward = bw
        return out
把 * 重载到 __mul__ 上之后,表达式本身一个字都不用改:你写 w1 * x1,拿到的不再是一个数,而是图上编号为 6 的那个节点.
走一遍
用开头那个表达式,逐个节点走一遍.$\sigma$、减法、平方都当作基本算子:
| 步 | 执行的操作 | 新节点 | 输入 |
|---|---|---|---|
| 1 | w1 = var(0.50) |
0 | — |
| 2 | x1 = var(1.20) |
1 | — |
| 3 | w2 = var(-0.30) |
2 | — |
| 4 | x2 = var(0.80) |
3 | — |
| 5 | b = var(0.10) |
4 | — |
| 6 | y = var(1.00) |
5 | — |
| 7 | t1 = w1 * x1 |
6 | (0, 1) |
| 8 | t2 = w2 * x2 |
7 | (2, 3) |
| 9 | s = t1 + t2 |
8 | (6, 7) |
| 10 | z = s + b |
9 | (8, 4) |
| 11 | a = σ(z) |
10 | (9) |
| 12 | d = a - y |
11 | (10, 5) |
| 13 | L = d * d |
12 | (11, 11) |
13 个节点:6 个叶子加 7 个操作节点.
t1 = w1 * x1          # 节点 6
t2 = w2 * x2          # 节点 7
s  = t1 + t2          # 节点 8
z  = s + b            # 节点 9
a  = sigmoid(z)       # 节点 10
d  = a - y            # 节点 11
L = d * d # 节点 12 ← 同一个节点用了两次注意最后一行——这就是表达式原文,没有 build_graph、没有 register、没有显式 new 节点.图是这七行代码执行时顺手长出来的.
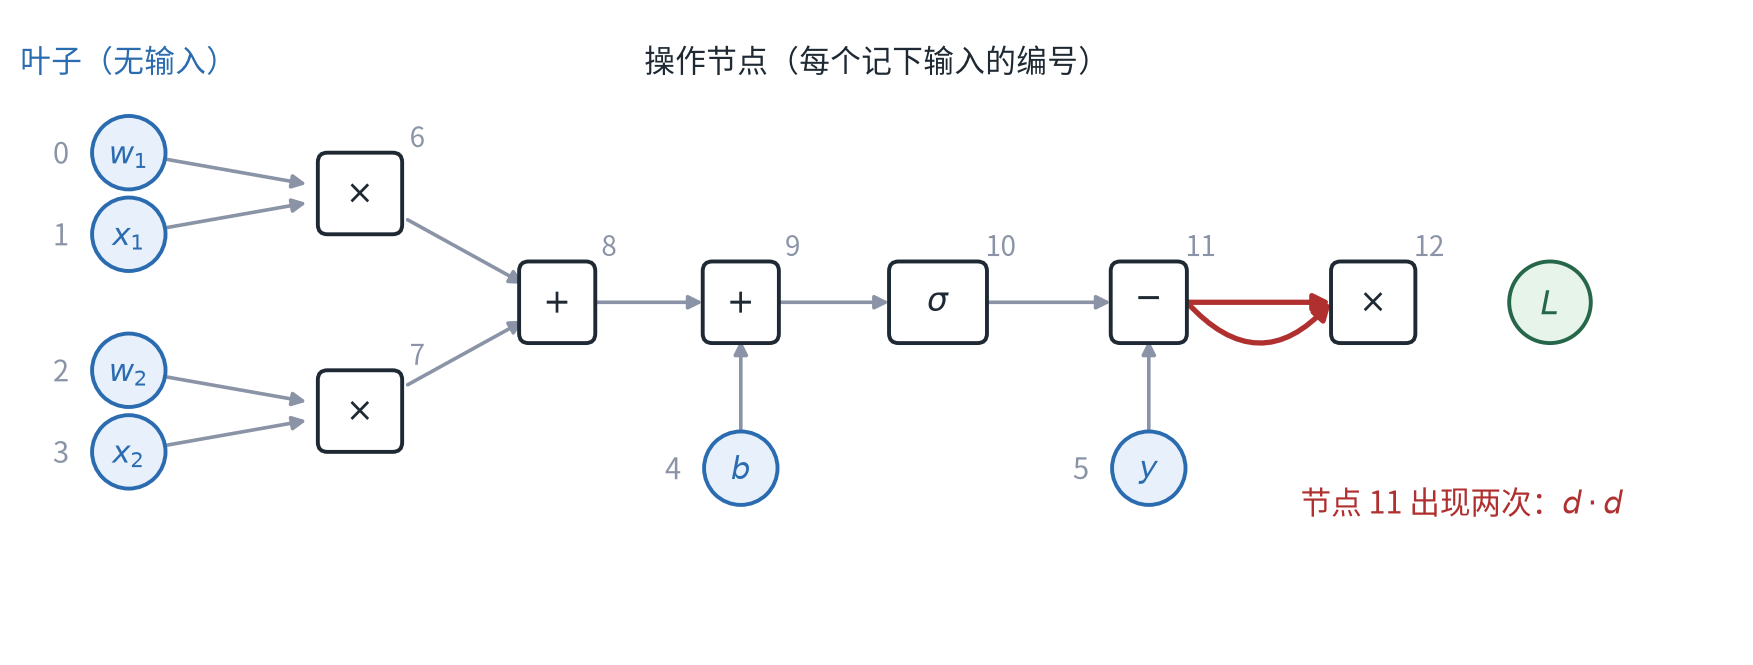
图 3:同一个表达式的图,节点编号标在旁边.红色那两条边来自同一个节点.
回到第 13 步:输入是 (11, 11),同一个节点出现了两次.这不是笔误,d*d 就是这样.
一个节点被下游用到不止一次,就叫扇出(fan-out)——同一份数值被分发给了多个消费者.这里是最小的情形:$d$ 扇出了两条边,而两条边通向同一个节点.
它带来一个直接后果:反向走到 d 时,两条边各送来一份梯度,两份都要加进去:
$$\bar d = \bar L \cdot d + \bar L \cdot d = 2d\,\bar L$$
(这里开始用上划线记号:在节点上写一横,就是对 $L$ 求偏导——比如眼前这个 $d$,
$$\bar d \;\equiv\; \frac{\partial L}{\partial d}$$
(严格说,那一横底下站的是这个节点的值,不是“顶点”这个对象——偏导只能对一个数求:
$$\bar d=\frac{\partial L}{\partial\,\mathrm{val}(d)}$$
$\mathrm{val}(d)$ 就是前面那个递归定义算出来的数.)
它在计算里是一个实实在在的东西:每个节点带两个浮点数——前向的值(代码里的 self.val)和反向的累加器(self.grad),后者就是 $\bar v$ 落脚的地方.反向传播从头到尾只在动这些累加器——不构造 Jacobian,也不解方程,只是不停地做同一件事:把上游送来的那份乘上本算子的局部导数,加到前驱的累加器里.
走完之后,参数节点上那个数就是 $\partial L/\partial w$.根节点上是 $\bar L=\partial L/\partial L=1$;一个节点被下游用了几次,那个累加器就要把那几份都收进来——这就是后面处处写 $\mathrel{+}=$ 的原因.)
平方的导数就这么自动出来了,不需要为它单独写一条规则.你只要会乘法的反向规则,$(\cdot)^2$ 的规则就是它的推论.这也说明图上的扇出和导数里的求和,在结构上是同一件事.
建图过程:编号是怎么来的
回看那张表会发现编号是乱的:0、1、6、2、3、7、8……原因是表是按图的结构排的(后序),而编号是按“什么时候被创建”发的.这两件事不一样.
创建顺序由表达式的求值顺序决定.sigmoid(w1*x1 + w2*x2 + b) - y 这一串,Python 从左到右、从内到外地算:
| 执行到 | 触发什么 | 新建节点 |
|---|---|---|
w1 = Node(0.50) …… y = Node(1.00) |
叶子构造 | 0, 1, 2, 3, 4, 5 |
w1 * x1 |
__mul__ |
6 |
w2 * x2 |
__mul__ |
7 |
t1 + t2 |
__add__ |
8 |
s + b |
__add__ |
9 |
sigmoid(z) |
函数内部建节点 | 10 |
a - y |
__sub__ |
11 |
d * d |
__mul__(此时 self is other) |
12 |
这就是全部过程.没有遍历表达式、没有分析语法、没有两趟.Python 解释器按它本来就要走的顺序把每个子表达式算出来,每一步顺手往图里追加一个节点.
想看真实发生的顺序,给 Node.__init__ 加一行就行:
print(f"新建 #{self.id} op={op} 值={val:.4f} 输入={[u.id for u in inputs]}")这里有一个可以直接拿去用的推论.因为每个节点只引用编号比它小的节点,按编号从大到小遍历,天然就是逆拓扑序——纯 tape 式的实现可以完全跳过 DFS.第四节末尾那个“可以绕开 DFS 的情形”,来历就在这里.
表达式树不等于计算图
这一条容易被忽略,但它直接影响你怎么写表达式.
考虑 (a+b)*(a+b).作为表达式树,它有两个独立的 a+b 子树.如果照字面写这行代码,拦截求值会把两次加法都录下来:
t1 = add(a, b)      # 节点 1
t2 = add(a, b)      # 节点 2   ← 重复了
out = mul(t1, t2) # 节点 3图里有两个加法节点,输入完全一样.
但如果先把结果存下来再用:
s = a + b           # 节点 1
out = s * s # 节点 2图里只有一个加法节点.
两张图算出来的梯度都对(重复的那个节点会把梯度分别送给 a 和 b,加起来正好),但第二张更小更快.图的形状取决于表达式怎么写,而不只取决于它是什么意思.
这就是公共子表达式消除(CSE)这类图优化存在的理由,也是为什么有些框架会建议你把重复的子表达式先赋给变量.
什么算“基本算子”
上面第 7 到 13 步里,我把 *、+、减法、$\sigma$、平方都当成了基本算子.但这是个选择,不是给定的:
-
只给
+和*:减法、除法、平方、$\sigma$ 都要展开成子图 -
给
+ - * /和一批初等函数:图小一些,但每一类都要配一条反向规则 -
再往上给
matmul、softmax、conv:图更小,但要手推的反向规则更复杂
算子集的选择决定了图长什么样,也决定了你要手写多少条反向规则.这是第五节的主题,先记着.
动态图与静态图
因为图是在求值过程中建出来的,所以每跑一次前向就得到一张新图.
好处是控制流天然可用:if 走哪个分支、循环转几圈,图上就是什么样子,不需要提前知道.
代价是每轮重建一次,而且图记的是“这次”的形状——换个 batch size 就是另一张图.
另一条路是先建一张图、反复跑(早期 TensorFlow 的做法).省了重建开销,也方便整体优化,但控制流要提前写进图里,很别扭.
现在的做法一般是先按求值建图,再把它捕获下来编译成静态的(torch.compile、JAX 的 tracing).两边的好处都要.
三、反向传播:在图上求梯度
图建好之后,求导只需要给每个操作节点配一条局部规则,负责把上游给它的梯度按本算子的局部导数分给它的前驱:
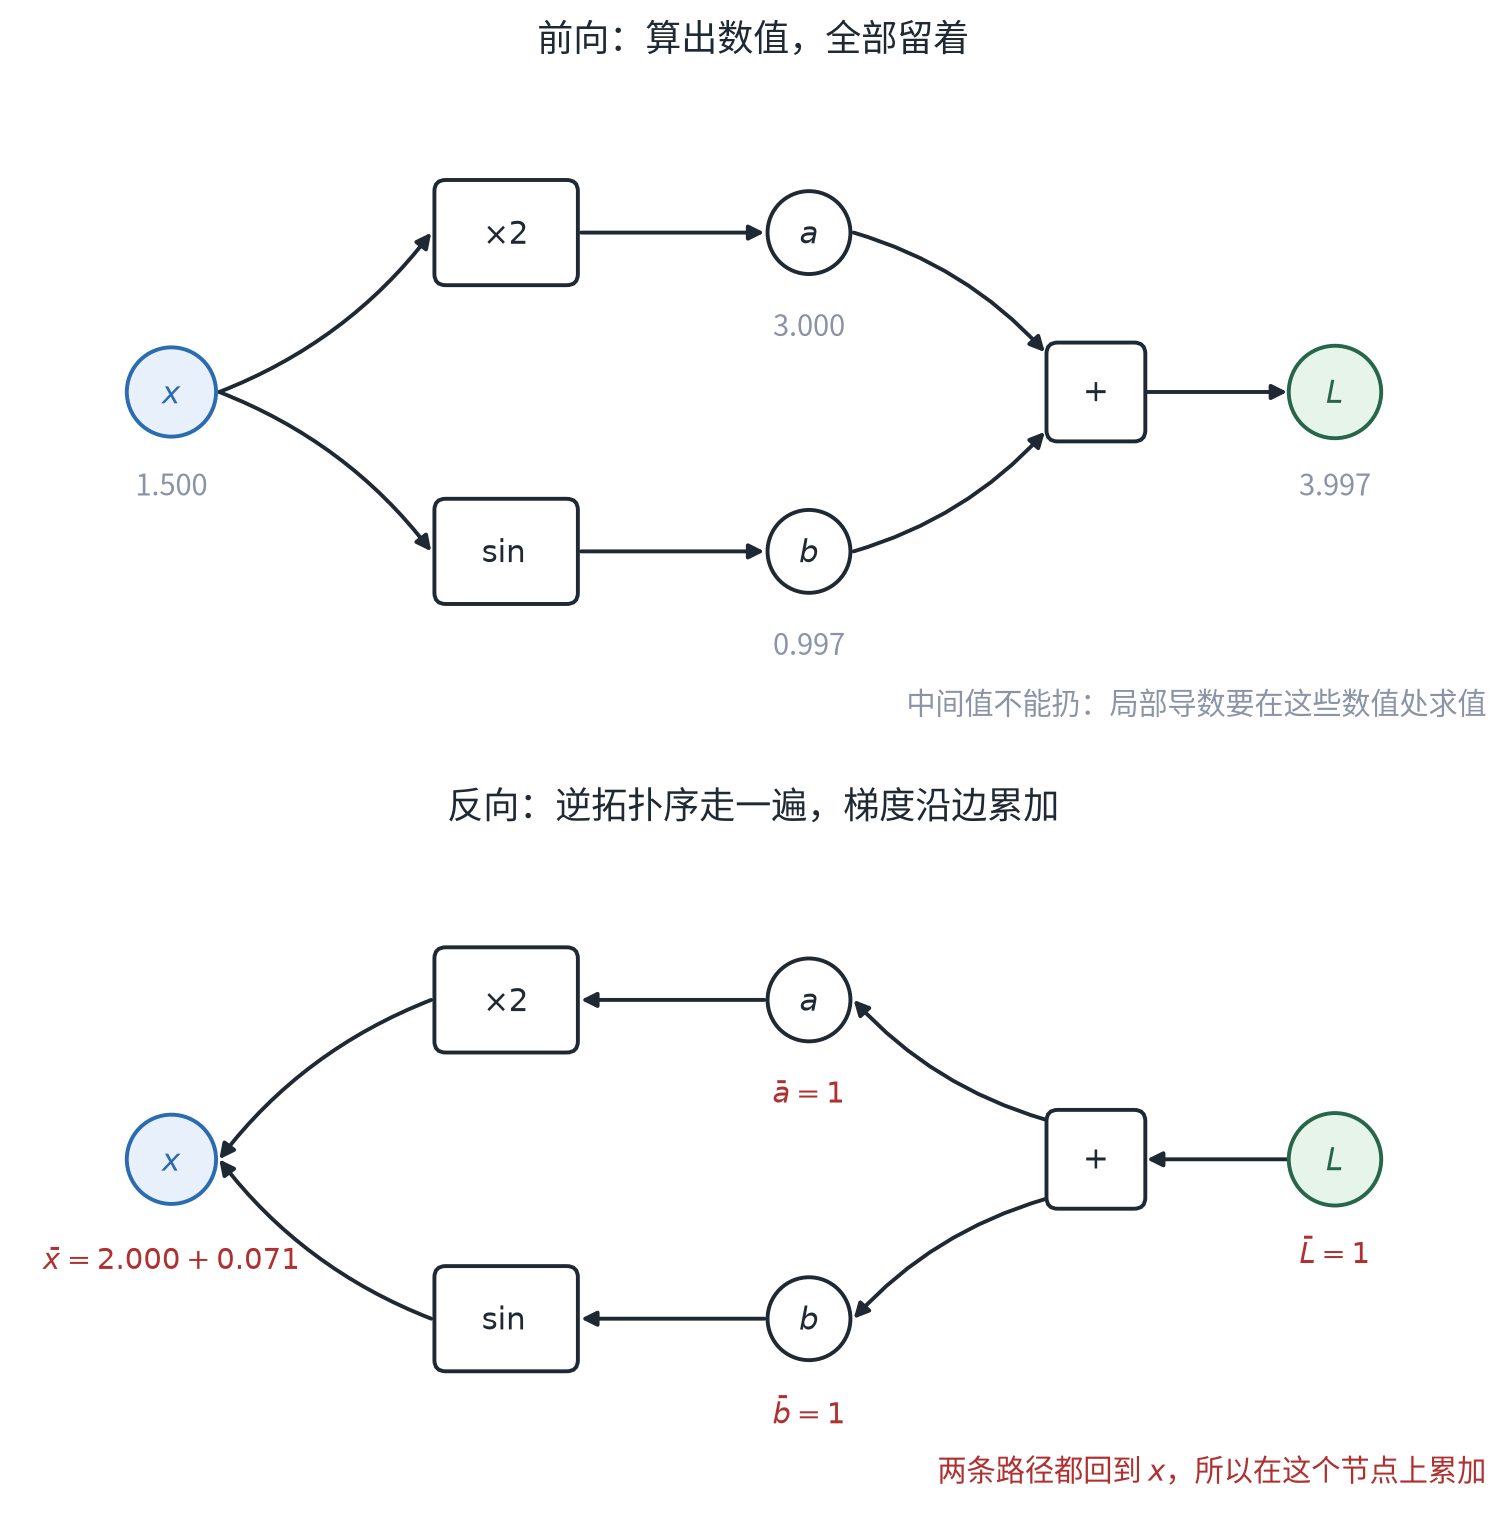
图 4:同一个计算图.前向走数值,反向走梯度.
| 算子 | 局部规则 |
|---|---|
| $y = a + b$ | $\bar a \mathrel{+}= \bar y$,$\bar b \mathrel{+}= \bar y$ |
| $y = a \times b$ | $\bar a \mathrel{+}= \bar y \cdot b$,$\bar b \mathrel{+}= \bar y \cdot a$ |
| $y = \sigma(a)$ | $\bar a \mathrel{+}= \bar y \cdot \sigma'(a)$ |
| $y = \sum_i a_i$ | $\bar a_i \mathrel{+}= \bar y$(广播回去) |
反向传播就是:从输出端播下种子 $\bar L = 1$,然后按某个顺序让每个节点执行自己那条规则.
def backward(root):
    order = topo_order(root)        # DFS 后序,下一节展开
    root.grad = 1.0                 # 播种子:dL/dL = 1
    for v in reversed(order):       # 逆拓扑序
v._backward() # 每个节点执行自己那条局部规则不到十行,一个标量自动微分引擎就有完整功能了.整套机制的复杂度全在“什么顺序”这四个字里,而那正是下一节的内容.
“某个顺序”这四个字下一节展开.先看两个细节.
为什么是 $\mathrel{+}=$ 而不是 $=$
一个节点可能扇出到多处——刚才 d*d 那个节点就是,$d$ 有了两条出边.$d$ 对 $L$ 的总贡献来自两条边,所以反向走到 $d$ 时两边的贡献都要加进去.写成 $=$ 就只保留了最后到达的那一条.
这也顺带解释了 PyTorch 里那句 optimizer.zero_grad() 为什么必须写:梯度默认是累加的,不清零就会跨 batch 越滚越大.
为什么一趟就够
这和“逐参数手算要 $n$ 遍”是同一个问题的两面.关键在于两种做法中间保存的量性质不同:
-
反向传播存的 $\partial L/\partial v$ 是损失对这个节点的敏感度,它和“你在对哪个参数求导”无关
-
逐参数手算存的 $\partial v/\partial w_i$ 绑死在那个特定的 $w_i$ 上
前者是共享量,一趟遍历每个节点只算一次,对所有参数都成立;后者换个参数就得把整张图重跑.$n$ 倍的差距全在这里.
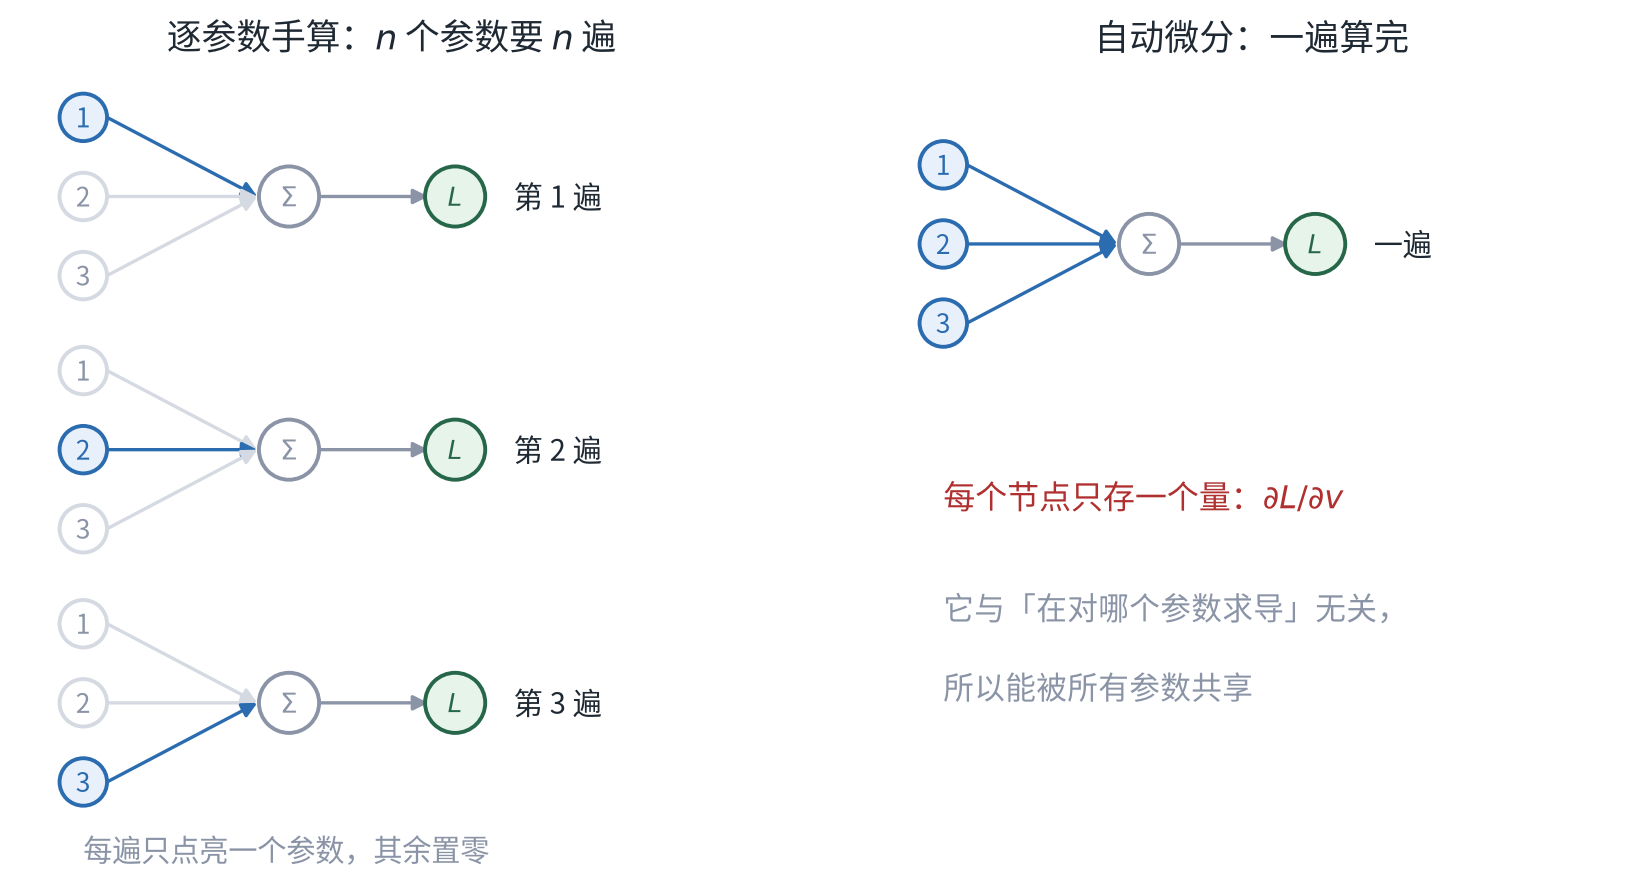
图 5:左边是 $n$ 遍,右边是一遍.区别不在算法技巧,在那个保存量的定义.
四、拓扑序:DFS 后序
为什么需要顺序
上面对“某个顺序”含糊过去了.现在把它说清楚.
一个节点的梯度是所有下游贡献之和.所以处理某个节点时,它的所有下游必须已经处理完——否则还有贡献没加进来,你就会拿着一个不完整的梯度去更新它的前驱.
满足这个条件的顺序叫逆拓扑序.
后序怎么给出来
从输出节点出发,沿着“前驱(输入)”边做深度优先搜索,并在一个节点的所有前驱都访问完之后才把它记进列表.这样得到的列表叫后序.
后序有一个直接的性质:任何一条边 $u \to v$($u$ 是 $v$ 的输入)上,$u$ 一定排在 $v$ 前面——因为 $v$ 要等它的前驱 $u$ 访问完才被记录.也就是说,后序本身就是一个拓扑序.把它反过来,就是反向传播需要的逆拓扑序.
def topo_order(root):
    order, seen = [], set()

    def visit(v):
        if id(v) in seen:           # 坑一:不标记,扇出节点会被重复展开
            return
        seen.add(id(v))
        for u in v.inputs:
            visit(u)                # 先把所有前驱走完
        order.append(v)             # 再把自己记下来  ← 这一行就是"后序"

    visit(root)
    return order
起作用的只有 order.append(v) 那一行的位置——放在循环前面前序,放在后面后序.位置换了,出来的东西就不能用了.
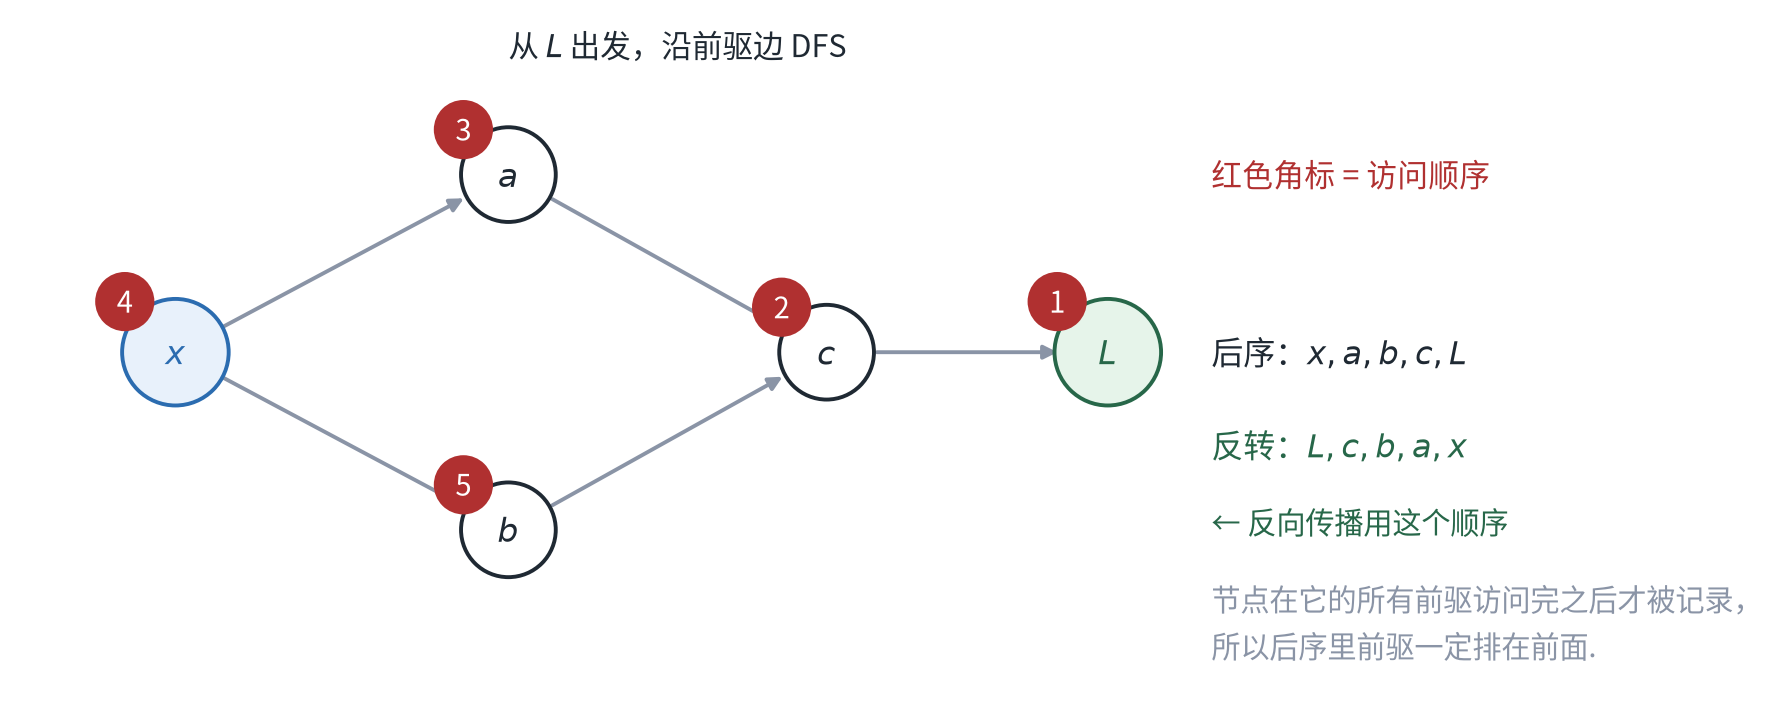
图 6:从 $L$ 出发沿前驱边 DFS,记录后序,再反转.
为什么不能随便遍历一遍再反转
这是最容易想错的地方.把前序反转,得不到逆拓扑序.
拿图 6 那张图试.前序遍历(从 $L$ 出发)得到
$$L,\ c,\ a,\ x,\ b$$
反转后是 $b, x, a, c, L$.第一个处理 $b$,但 $b$ 的梯度来自 $c$,而 $c$ 排在第四位——$b$ 拿到的是一个尚未完整的梯度的零头.
后序就不一样:节点被记录的前提是它的前驱全部处理完,所以反转之后,处理任何节点时它的所有下游必然已经就位.“什么时候把自己的名字写上去”这一个动作,就是后序和前序的全部差别.
实现上的三个坑
① 访问标记是必需的.没有它,一个扇出节点(第二节那个 $d*d$)会被重复展开,复杂度从 $O(V+E)$ 退化成指数级.标记用一个布尔数组或哈希集合都行.
② 深图会把递归爆掉.递归版 DFS 的栈深度等于图的最长路径.几千层的网络加上展开后的算子数量,很容易超过线程栈.生产实现一般用显式栈或迭代版.
③ 每轮训练都要重置标记.遍历几百万个节点只为了清零,是纯浪费.常见做法是给每个节点存一个“代数”字段,和全局计数器比对——不一致就当作未访问,这样重置只需把计数器加一.
一个可以完全绕开 DFS 的情形
先补一句前面跳过的话.图给的是偏序,遍历要的是全序.
只有有路径相连的两个节点之间才有先后约束.拿菱形图 $a\to b,\ a\to c,\ b\to d,\ c\to d$ 来说,合法的拓扑序有两种:
$$a,b,c,d\qquad\text{和}\qquad a,c,b,d$$
图并不指定是哪一种.所以从偏序到全序,中间必须选一次,而图本身不提供这个选择.
下面看 tape 怎么把这个选择偷偷做掉.
如果节点 id 是按创建顺序严格递增分配的,并且每个节点只引用比它更小的 id,那么按 id 从大到小遍历,天然就是逆拓扑序,根本不需要 DFS.
这不是巧合——它正是 tape 式设计(一块连续内存、按下标引用节点)的核心性质:节点追加进数组,id 就是下标,而追加必然晚于它的输入,于是下标升序自动是一个合法的全序.那个本该由你做的选择,被内存分配顺手做了.
代价是参数和中间值必须共享同一块地址空间.一旦分开存放(参数一块、每轮的计算图一块),“谁先谁后”这句话就失去意义了——参数在 A 区是下标 $500000$,中间值在 B 区是下标 $3$,两块独立数组之间没有可比的下标.id 的全局单调性一断,就只能回去做 DFS.
所以“要不要拓扑排序”不是算法选择,是内存布局选择的结果.
五、从标量到张量:算子粒度
第二节图 3 那种做法在数学上没有毛病,工程上完全不可用.一个 $1000\times1000$ 的矩阵乘法会展开成 $10^9$ 个标量节点,每个节点一次分派、一次内存访问,中间值全是散落的标量.所以真实的 AD 系统不会把矩阵乘法拆成标量——它把 $mnk$ 个标量乘法融合成一个算子.
但融合不是免费的.代价不在前向,在反向.这一节先把账算清楚,下一节再补上背后的数学.
融合的代价:反向规则必须手推
现在说融合的代价,它常被忽略:融合出来的新算子,它的反向规则没法从标量规则自动组合出来,必须人手推一遍.
以 $Y = AB$($A$ 是 $m\times k$,$B$ 是 $k\times n$)为例.它的导数 $\partial Y/\partial A$ 有 $m\cdot n\cdot m\cdot k$ 个元素——比 $A$ 自己($mk$ 个)大了 $mn$ 倍.没有人会去构造它.实际写进代码的是它的转置怎么作用:
$$\bar A = \bar Y B^\top, \qquad \bar B = A^\top \bar Y$$
这一行不是自动推出来的,是手推出来然后写死的.逐元素算子的情形稍好:Jacobian是对角矩阵,只需要存对角线,也就是 $\varphi'(x)$ 本身.
还有一类在标量世界里不存在的东西——广播.
它是形状不同的数组做逐元素运算时的规则:从右往左对齐,逐轴比较——相等、或者其中一个为 $1$ 就兼容,长度为 $1$ 的轴会像被复制了一样展开.$(B,m)$ 和 $(m,)$ 能相加,就是因为右对齐之后是
$$(B,\ m)\quad\text{和}\quad(1,\ m)$$
第二轴都是 $m$,第一轴是 $B$ 对 $1$——兼容,结果是 $(B,m)$.(注意是从右往左:$(3,4)$ 和 $(3,)$ 右对齐成 $(3,4)$ 和 $(1,3)$,$4\ne3$,直接报错.)
(实现上并不真的复制——把被广播那一轴的 stride 设成 $0$,取任何下标都落到同一块内存.但语义上就是复制,反向时必须把这笔账还回去.)
拿 $(B,m)+(m,)$ 来说:正向的 $b$ 被复制了 $B$ 次,反向就要把这 $B$ 份的贡献收回一处——沿 batch 轴求和.这个规则同样得手推,而且它是手写张量 AD 里最高频的 bug 来源——广播出去的轴忘了 reduce 回去.自查的办法很简单:算出来的 $\bar b$ 必须退回到 $b$ 原来的形状,从 $(B,m)$ 缩回 $(m,)$.
举个能算完的例子.取 $B=2$、$m=3$:
$$b=\begin{bmatrix}1&2&3\end{bmatrix},\qquad X=\begin{bmatrix}10&20&30\\40&50&60\end{bmatrix}$$
($b$ 写成一排,因为广播时它右对齐成 $(1,3)$ 的样子.它真正的形状是 $(3,)$——一维数组没有行列之分.写成列反而会误导:那暗示形状 $(3,1)$,而 $X$ 的形状 $(2,3)$ 和 $(3,1)$ 右对齐之后第 $0$ 轴是 $2$ 对 $3$,直接报错.)
正向 $Y=X+b$,$b$ 被复制成两行,再逐元素相加:
$$Y=\begin{bmatrix}10&20&30\\40&50&60\end{bmatrix} +\begin{bmatrix}1&2&3\\1&2&3\end{bmatrix} =\begin{bmatrix}11&22&33\\41&52&63\end{bmatrix}$$
中间那一块是 $b$ 复制出来的两行——它并不真的占内存(那一轴的 stride 是 $0$),写出来只是为了看清发生了什么.
反向任给一个上游梯度 $\bar Y=\begin{bmatrix}1&0&2\\3&1&0\end{bmatrix}$(形状 $(2,3)$),则
$$\bar b=\begin{bmatrix}1+3&0+1&2+0\end{bmatrix}=\begin{bmatrix}4&1&2\end{bmatrix}, \qquad \bar X=\bar Y$$
盯住形状的走向:正向 $(3,)\to(2,3)$,一行变两行;反向 $(2,3)\to(3,)$,两行加回一行——两个方向的形状正好相反.
“优化算子”其实是三件事
工程上大家说“优化算子”的时候,混在一起的是三个不同层次的东西,它们的代价完全不同:
| 层次 | 做什么 | 数学变了吗 | 代价 |
|---|---|---|---|
| 算子粒度(设计期) | 决定暴露哪些算子:给 matmul + add + relu 三个,还是给一个 linear_relu |
变了 | 复合算子的反向规则要手推 |
| 编译期融合 | 在已有算子上做 kernel 合并,中间结果留在寄存器里不回显存 | 没变 | 不用重推反向规则,但反向需要的中间值得额外带出来 |
| 手写融合算子 | 像 FlashAttention 那样,把 $\mathrm{softmax}(QK^\top)V$ 整块写成一个算子 | 变了 | 既要手推反向,反向里还常常要重算中间值 |
第二层是编译器干的活(torch.compile 那一类系统),它在 autograd 已经把图拆成基本算子之后再做融合——所以融合不会破坏自动求导.
第一层和第三层是人干的活.这就是为什么需要算子工程师:融合到什么粒度,是一个“通用性换性能”的取舍,而这个取舍没有标准答案.融合越细,AD 越通用但越慢;融合越粗,越快但每加一个算子就要多手推一份反向,而且反向里的数值稳定性、内存占用都得重新设计.
FlashAttention 是第三层的典型:它省掉了 $n\times n$ 注意力矩阵的显存,代价是反向传播时没法直接取用那个矩阵,只能重算.融合省下的内存,在反向那一侧又讨回去了一部分.
到这里,工程侧的三层取舍讲完了.但有一个问题一直被绕过去:那些要手推的反向规则,凭什么长成那个样子?为什么不能像标量算子那样自动组合出来?
答案在导数的定义里.下一节从三个最简单的形状开始.
六、导数的形状
上一节说,融合的代价是那些反向规则必须手推.这一节先把这些导数长什么样、怎么算说清楚——具体地、不引入任何新定义.
至于“为什么形状一定是这样”,留到第八节.
先看三个熟悉的情形
抽象之前,先把三个大家都见过的东西并排放.
① $\mathbb{R}\to\mathbb{R}$.$y=f(x)$,导数 $f'(x)$ 是一个数.
② $\mathbb{R}^n\to\mathbb{R}$.损失 $L(w_1,\dots,w_n)$.每个自变量配一个偏导,排成一列就是梯度:
$$\nabla L=\begin{bmatrix}\partial L/\partial w_1\\ \vdots\\ \partial L/\partial w_n\end{bmatrix}$$
$n$ 个数.
③ $\mathbb{R}^n\to\mathbb{R}^m$.$y=f(x)$.每个输出分量对每个输入分量都有一个偏导,把 $f_i$ 的那几个摆在第 $i$ 行,就是Jacobian 矩阵:
$$J=\begin{bmatrix} \partial f_1/\partial x_1 & \cdots & \partial f_1/\partial x_n\\ \vdots & & \vdots\\ \partial f_m/\partial x_1 & \cdots & \partial f_m/\partial x_n \end{bmatrix}$$
$m\times n$ 个数.
这里要点破一件事:$\partial y/\partial x$ 是一个整体记号,不是“$\partial y$ 除以 $\partial x$”.一维时它确实是个商(差商的极限),但高维时分母是向量,除法根本没有定义——那个分数形状是从一维继承下来的写法.它真正的内容就是上面这一步:每个输出分量对每个输入分量各求一次偏导,然后把结果排成一张表.
(再往上一层,$A$、$B$ 都是张量时也一样:$\partial A/\partial B$ 就是“每个 $A$ 的分量对每个 $B$ 的分量各求一次偏导”,全部摆在一起,指标数是两者之和.第八节会给完整的账.)
规律
三个并排放,形状的规律就浮出来了:
| 输入大小 | 输出大小 | 阶数 | 元素个数 | |
|---|---|---|---|---|
| ① | $1$ | $1$ | 0 | $1$ |
| ② | $n$ | $1$ | 1 | $n$ |
| ③ | $n$ | $m$ | 2 | $mn$ |
两件事同时成立:元素个数总是“输入大小 × 输出大小”,阶数则等于“输入指标数 + 输出指标数”.
这不是巧合,但光看公式看不出来为什么.要给个说法,得回到导数的定义——那是第八节的事,先往下走.
Jacobian 矩阵的几个细节
③ 里那个矩阵值得单独说几句.定义不重复了,只说三件事.
形状为什么是 $m\times n$.行数等于输出的维数,列数等于输入的维数——这不是口诀,是“第 $i$ 行记的是 $f_i$ 对所有输入的偏导”直接读出来的.
它做什么.它把输入的每个方向线性地映成输出的一个方向.在 $x$ 附近
$$f(x+\delta)=f(x)+J\,\delta+o(\|\delta\|)$$
$J\delta$ 是矩阵乘向量:$J$ 的每一行和 $\delta$ 做一次内积,得到输出的一个分量.所以 $Jv$ 就是 $f$ 沿方向 $v$ 的变化率.
下面三件事,每一件后面都会用到.
副产品:梯度为什么有时候写行、有时候写列
标量函数 $L:\mathbb{R}^n\to\mathbb{R}$ 的 Jacobian 是 $1\times n$ 的,一行.$\partial L/\partial w_i$ 只带一个下标、看着像行向量,原因就在这里.
但平时画梯度习惯画成列向量,因为要拿它做更新:$w\leftarrow w-\eta\nabla L$ 里减去的必须和 $w$ 同形状($n\times 1$).行变列要用转置——或者等价地,事先约定一个内积把两者等同起来.
同一篇文章里梯度一会儿行一会儿列,根源就在这.记形状时用行(跟着指标的排法),做参数更新时用列(跟着向量的排法),两个都不算错.
链式法则为什么是矩阵乘法
一维的链式法则是两个数相乘:
$$(g\circ f)'(x)=g’\big(f(x)\big)\cdot f'(x)$$
到高维,把数换成算子:
$$D(g\circ f)(x)=Dg\big(f(x)\big)\circ Df(x)$$
右边是算子的复合.写成矩阵,复合就是矩阵乘法:
$$J_{g\circ f}(x)=J_g\big(f(x)\big)\cdot J_f(x)$$
形状自动对上:$J_g$ 是 $k\times m$,$J_f$ 是 $m\times n$,乘起来 $k\times n$,正好是 $g\circ f:\mathbb{R}^n\to\mathbb{R}^k$ 的 Jacobian.写完扫一眼形状,就知道有没有乘反.
但“把数换成算子、再写成矩阵乘法”这一步凭什么合法?为什么不是逐元素相乘、不是别的运算?
因为导数本来就是最佳线性逼近,而线性逼近复合起来还是线性逼近.把两段余项代进去,这件事自己就出来了.
设 $y=f(x)$,$f$ 在 $x$ 处、$g$ 在 $y$ 处可微:
$$f(x+h)=f(x)+Df(x)h+r_f(h),\qquad r_f(h)=o(\|h\|)$$
$$g(y+k)=g(y)+Dg(y)k+r_g(k),\qquad r_g(k)=o(\|k\|)$$
直接代入:
$$g\big(f(x+h)\big)=g(y)+Dg(y)\big[Df(x)h+r_f(h)\big]+r_g\big(Df(x)h+r_f(h)\big)$$
把线性部分拎出来单独放:
$$=g(y)+\underbrace{\big[Dg(y)\circ Df(x)\big]h}_{\text{线性部分}}+\underbrace{Dg(y)\,r_f(h)+r_g\big(Df(x)h+r_f(h)\big)}_{\text{余项}}$$
两个余项都还是 $o(\|h\|)$:
-
$Dg(y)$ 是有界算子,所以 $\|Dg(y)r_f(h)\|\le\|Dg(y)\|\cdot\|r_f(h)\|=o(\|h\|)$
-
$\|Df(x)h+r_f(h)\|\le(\|Df(x)\|+o(1))\|h\|=O(\|h\|)$,把它代进 $r_g$ 仍然是 $o(\|h\|)$
于是 $g\circ f$ 在 $x$ 处可微,导数正是 $Dg(y)\circ Df(x)$.
链式法则的全部内容就是这一句:线性逼近的复合还是线性逼近,而且余项压得住.写成坐标,就是 Jacobian 矩阵相乘——不是“矩阵乘法恰好成立”,是“复合这个运算在坐标下的样子就是矩阵乘法”.
(顺带一句:这里“有界”两个字是干活的.有限维不用管,但整个论证的落点就在那条不等式上.)
为什么偏偏是逐元素减
减的是什么,前面已经回答了.但还有一个问题被跳过去了:为什么是这个减法——逐元素、共享同一个 $\eta$?
分两层,第二层才是关键.
第一层:参数和梯度住在同一个向量空间里.
$W$ 是 $m\times n$,$\partial L/\partial W$ 也是 $m\times n$.它们不是两类东西,是同一个向量空间里的两个元素,只是恰好被排成了二维数组的形状.
所以 $W-\eta\,\partial L/\partial W$ 是向量减法;而向量减法落到坐标上,就是逐个坐标相减.逐元素不是额外规定的规则,是“把数组当成坐标”之后的必然样子.
第二层:为什么是减、不是加.
这个第一节证过——负梯度是同样步长下下降最快的方向.所以“朝这个方向走一步”就写成
$$W\leftarrow W-\eta\,\nabla_WL$$
两层加起来,似乎就够解释逐元素了.但其实不够——“逐元素、共享同一个 $\eta$”里藏着一个没明说的选择.下一节把它拆开.
梯度下降其实是每步解一个小问题
那个没明说的选择是:“逐元素、共享同一个 $\eta$”等价于用 Frobenius 范数来度量“一步走了多远”.
把梯度下降写成“每一步解一个小优化问题”,这句话立刻现形.每一步要最小化的东西是
$$\Phi(W)=L(W_k)+\big\langle \nabla L(W_k),\,W-W_k\big\rangle_F+\frac{1}{2\eta}\big\|W-W_k\big\|_F^2$$
而 $W_{k+1}$ 就是让 $\Phi$ 取到最小的那个 $W$.
换句话说:站在 $W_k$ 上,一阶展开只在脚边可信,那么“往哪走、走多远”最划算?上面这个 $\Phi$ 就是把这个问题写成了式子.
先说记号. $L$ 是损失函数,$W$ 是 $m\times n$ 的矩阵,所以这里用的是 Frobenius 内积和 Frobenius 范数,不是矩阵乘法:
$$\langle A,B\rangle_F=\sum_{ij}A_{ij}B_{ij}=\operatorname{tr}(A^\top B), \qquad \|A\|_F^2=\sum_{ij}A_{ij}^2$$
换句话说,矩阵在这里是被摊平当向量用的.把 $W$ 按行拉直成 $\operatorname{vec}(W)\in\mathbb{R}^{mn}$,则
$$\operatorname{vec}(A)^\top\operatorname{vec}(B)=\sum_{ij}A_{ij}B_{ij}=\langle A,B\rangle_F$$
Frobenius 内积就是“摊平之后的点积”.(写成 $\nabla L^\top(W-W_k)$ 也不算错,但对着矩阵看会误以为要做矩阵乘法——量纲都对不上.所以下面一律把 $F$ 写出来.)
为什么中间那一项是内积?这不是挑的,是链式法则给的.$L$ 的全微分是
$$dL=\sum_{ij}\frac{\partial L}{\partial W_{ij}}\,dW_{ij}$$
右边这个求和逐字就是偏导矩阵与 $dW$ 的 Frobenius 内积.一阶项长成内积,是因为链式法则在坐标下本来就长这样.
还有更深的一层,后面要用到.固定 $W_k$,导数是映射
$$d\;\longmapsto\;\text{沿 } d \text{ 的变化率}$$
它是线性的,也就是一个线性泛函.而 Riesz 表示定理说:完备的内积空间上,每个连续线性泛函都能唯一写成 $\varphi(d)=\langle g,d\rangle$ 的形式.这里全程是有限维,而有限维内积空间自动完备(线性泛函也自动连续)——条件全自动满足.
这条定理下面当现成结论用,不展开证.有限维的情形顺手一提就够了:先用 Gram–Schmidt 把任意一组基正交化,得到单位正交基 $e_1,\dots,e_n$.正交基的好处是坐标就是内积——
$$d=\sum_i\langle d,\,e_i\rangle\,e_i$$
于是直接取
$$g=\sum_i\varphi(e_i)\,e_i$$
代进去就行:
$$\langle g,d\rangle=\sum_i\varphi(e_i)\langle e_i,d\rangle=\varphi\Big(\sum_i\langle d,e_i\rangle\,e_i\Big)=\varphi(d)$$
(第一步用内积的双线性,第二步用 $\varphi$ 的线性.唯一性也是两行:若 $\langle g,d\rangle=\langle g’,d\rangle$ 对所有 $d$ 成立,取 $d=g-g’$ 就得到 $\|g-g’\|^2=0$.)
那个 $g$,就是“梯度”的定义.所以与其说“一阶项碰巧写成了内积”,不如说:“梯度”这个词的意思,就是“把导数这个泛函用内积表示出来的那个向量”.换一把内积,就换一个梯度——这一节结尾会回到这一点.
令 $d=W-W_k$(这一步的位移),三项各就各位:
| 项 | 含义 |
|---|---|
| $L(W_k)$ | 和 $d$ 无关,不影响最小值落在哪.写在这里只是让整个式子读起来像“新点的损失” |
| $\langle \nabla L(W_k),\,d\rangle_F$ | 如果损失真是线性的,走 $d$ 之后损失会变这么多 |
| $\dfrac{1}{2\eta}\|d\|_F^2$ | 走远的罚金,按 Frobenius 距离的平方增长 |
第三项不能省.没有它,只要 $\nabla L\ne 0$,取 $d=-t\nabla L$ 让 $t\to\infty$ 就能把一阶项压到 $-\infty$——最优解成了“沿负梯度走无穷远”,荒谬.
根子在于一阶展开离远了根本不可信.第三项就是把可信范围编码进去:方向可以信,距离不能信.
求极小:对 $d$ 求梯度(第二项线性、第三项二次,直接配方即可)得 $\nabla L+\frac{1}{\eta}d=0$,解出
$$d=-\eta\,\nabla L(W_k)$$
正是梯度下降.它是这个子问题的精确解,不是什么近似.
注意 $\eta$ 在式子里出现了两次,而且互为倒数:罚金系数是 $\dfrac{1}{2\eta}$,解出来的步长是 $\eta$.所以
$\eta$ 大 = 罚得轻 = 敢走远 = 步子大.
学习率就是“对走远的惩罚有多重”的反面——这句话让 $\eta$ 不再是个玄学常数.
代一组数看看.取 $L(w)=(w-3)^2$,$w_0=0$,$\eta=0.1$.此时 $L(0)=9$,$\nabla L(0)=-6$,子问题化成
$$\min_d\;\;9-6d+5d^2$$
开口向上的抛物线,顶点在 $d=0.6$,所以 $w_1=0.6$——和直接套 $w-\eta\nabla L$ 得到的一样.
这个视角还顺带说明一件事:子问题永远有唯一解.第三项的 Hessian 是 $\frac{1}{\eta}I$,正定;所以不管 $L$ 本身凸不凸、多难看,这个二次子问题都是严格凸的,解存在且唯一.
现在可以回答最开始那个问题了.第三项取 Frobenius 范数,展开到坐标就是
$$\|d\|_F^2=\sum_{ij}d_{ij}^2$$
——每个坐标的权重都是 1.所以每个坐标拿到同样比例的步长.“逐元素、共享 $\eta$”就是从这里来的.
这也接回了前面 Riesz 那一句:梯度是“把导数泛函用内积表示出来”的产物,内积换了,梯度和更新式都跟着换.所以“逐元素减”是一个度量选择的产物,不是天经地义的.
(上面全程只用 Frobenius 内积.换成别的范数会得到别的更新式——那是另一条线,这里不展开.)
自动微分里为什么从不构造它
先把记号定下来.只看一层:输入 $x\in\mathbb{R}^n$、输出 $y=f(x)\in\mathbb{R}^m$,这一层的局部 Jacobian 记作
$$J=\frac{\partial y}{\partial x}\qquad(m\times n)$$
整条链的末端是一个标量损失,写成
$$L=\ell(y)$$
——$\ell$ 就是把输出映成损失的那一段(所以 $\bar y=\nabla_y\ell$ 就是它的导数).
顺序要写清:数据先过 $f$、再过 $\ell$,
$$x\xrightarrow{\ \ f\ \ }y\xrightarrow{\ \ \ell\ \ }L, \qquad\text{合起来就是}\qquad L=(\ell\circ f)(x)$$
复合记号 $\circ$ 的规矩是右边先作用——$\ell\circ f$ 读作“先 $f$ 后 $\ell$”;下面写算子复合 $D\ell(y)\circ Df(x)$ 时同理,$Df$ 在右边先作用、$D\ell$ 在左边后作用.两者是同一个顺序,不用另记一套.
$J$ 有 $m\cdot n$ 个元素.一个 $1000\times1000$ 的线性层,Jacobian就是 $10^6\times10^6$,$10^{12}$ 个数.而把它乘到一个向量上只要 $O(mn)$.
所以整个 AD 系统里没有任何一步会把 $J$ 写出来.它只做两件事:把 $J$ 乘到一个向量上,或者把 $J^\top$ 乘到一个向量上.
-
前向:$\dot y=J\dot x$ —— 向量在右边
-
反向:$\bar x=J^\top\bar y$ —— 向量在左边(写成行向量就是 $\bar x^\top=\bar y^\top J$)
这两个乘积在文献里有名字:前者叫 JVP(Jacobian-vector product,Jacobian乘向量),后者叫 VJP(vector-Jacobian product,向量乘 Jacobian).读 JAX 或 PyTorch 的文档时会一直碰到这两个缩写——它们说的就是这两行.
拿一个两层网络走一遍,就知道“不构造”到底省掉了什么.一批 $B$ 个样本,输入 $n$ 维、隐层 $h$ 维、输出 $m$ 维:
$$X\xrightarrow{\;W_1,\,b_1\;}Z_1\xrightarrow{\ \sigma\ }H\xrightarrow{\;W_2,\,b_2\;}Z_2\xrightarrow{\ L\ }\text{标量}$$
($X$ 是 $B\times n$,$W_1$ 是 $n\times h$,$W_2$ 是 $h\times m$,损失取 $L=\frac12\|Z_2-T\|^2$.)
反向从 $L$ 出发,一路走到每一个参数:
| 步骤 | 式子 | 形状 |
|---|---|---|
| 播种子 | $\bar L=1$ | 标量 |
| 损失 | $\bar Z_2=Z_2-T$ | $B\times m$ |
| 第二层权重 | $\bar W_2=H^\top\bar Z_2$ | $h\times m$ ← 和 $W_2$ 同形 |
| 第二层偏置 | $\bar b_2=\mathbf 1^\top\bar Z_2$ | $m$ ← 和 $b_2$ 同形 |
| 传给隐层 | $\bar H=\bar Z_2W_2^\top$ | $B\times h$ |
| 过激活 | $\bar Z_1=\bar H\odot\sigma'(Z_1)$ | $B\times h$ |
| 第一层权重 | $\bar W_1=X^\top\bar Z_1$ | $n\times h$ ← 和 $W_1$ 同形 |
| 第一层偏置 | $\bar b_1=\mathbf 1^\top\bar Z_1$ | $h$ ← 和 $b_1$ 同形 |
| 传给输入 | $\bar X=\bar Z_1W_1^\top$ | $B\times n$ |
每一行的右边都只用到“上游送来的那个 $\bar{\cdot}$”和“这一层的权重”——自始至终没有出现过任何 Jacobian.播完种子之后每一步都是一次 VJP;参数那一列和“传给上一层”那一列共用同一个 $\bar Z$,只是换了权重乘的方向.
真去构造会怎样.比如第一层的 $\partial Z_1/\partial X$,它是 $Bh\times Bn$ 的:
$$\underbrace{B^2nh}_{64^2\times512\times1024\approx2.1\times10^9\text{ 个数(约 8.6 GB)}}\quad\text{vs}\quad\underbrace{Bnh}_{64\times512\times1024\approx3.4\times10^7\text{ 次乘加}}$$
左边是把 Jacobian 写出来要存的东西,右边是 $\bar X=\bar Z_1W_1^\top$ 实际要做的运算.差了五个数量级,而且那个大矩阵里绝大多数元素根本用不到——反向传播只需要它和某一个向量的乘积,而那个乘积能用权重矩阵直接算出来,不必先把 Jacobian 拼出来再乘.
这就是这一节标题的全部内容:不构造它,不是因为懒,是因为要的东西从来就不是它本身.
说清一句容易含混的事:VJP 确实给出梯度,但它给的是“对输入的梯度”,不是“对参数的梯度”.——$\bar x$ 是它对输入端交出来的东西,而 $\bar W$ 得换一个 Jacobian 另算一份.
单看一层.设第 $i$ 层是 $x_i=f_i(x_{i-1})$、局部 Jacobian 是 $J_i$,那么这一层的 VJP 就是
$$\bar x_{i-1}=J_i^\top\,\bar x_i$$
右边得先有一个 $\bar x_i$,它才动得起来——所以 VJP 本身不“产生”梯度,它只是把上游已经有的那份换个位置、换成对输入的.把各层串起来:
$$\bar x_0=J_1^\top J_2^\top\cdots J_L^\top\,\bar L,\qquad \bar L=\frac{\partial L}{\partial L}=1$$
“VJP 接 VJP”,种子在最右端.中间那些 $\bar x_i$ 都还只是半成品,要等链条走完才成形.
但参数不在那条链的末端.上面算出来的是 $\bar x_0$——对输入的梯度.参数同样是叶子,它的梯度也由 VJP 送来,只是换一个 Jacobian.以 $y=Wx$ 为例,同一层、同一个 $\bar y$,两条 VJP 并行:
$$\bar x=\Big(\frac{\partial y}{\partial x}\Big)^\top\bar y=W^\top\bar y,\qquad \bar W=\Big(\frac{\partial y}{\partial W}\Big)^\top\bar y=\bar y\,x^\top$$
第二行就是我们要的参数对上一层的梯度.
为什么右边是外积?把 $y=Wx$ 写成坐标就清楚了:$y_i=\sum_j W_{ij}x_j$,于是 $\partial y_i/\partial W_{kl}=\delta_{ik}\,x_l$,代入
$$\frac{\partial L}{\partial W_{kl}}=\sum_i\bar y_i\,\frac{\partial y_i}{\partial W_{kl}}=\bar y_k\,x_l$$
第 $(k,l)$ 个元素就是 $\bar y_kx_l$,逐元素写开正是外积.形状也对得上:$\bar y$ 是 $m$ 维、$x$ 是 $n$ 维,$\bar yx^\top$ 是 $m\times n$,与 $W$ 同形.
一次反向,输入和参数同时拿到梯度——这才是“一趟算完”的具体含义:不是遍历次数变少了,而是同一个 $\bar y$ 被复用了两次(有几组参数就复用几次).
上面我们讨论了只有一个线性层的情形.接下来是多层:先把每个结点中值对损失的梯度记作 $\bar v=\partial L/\partial v$.它有两个特点:
-
是累加出来的——一个节点扇出到几处,$\bar v$ 就是那几条边送来的贡献之和(局部规则里写 $\mathrel{+}=$,为的就是这个)
-
与求导对象无关——$\partial L/\partial v$ 不问你最后要对哪个参数求导,只看从当前节点到损失的路径,所以一遍就能把整张图的 $\bar v$ 全算出来
反向传播只往 $\bar v$ 里累加,参数一个字节都不动.等所有 $\bar v$ 攒完,参数叶子上的那些就是 $\partial L/\partial W$,交给优化器;减法只发生在那儿:
$$W\leftarrow W-\eta\,\bar W$$
那为什么往回搬要乘 $J^\top$?前面那条 Riesz 已经答了:梯度是“把导数这个泛函用内积表示出来的向量”.写成内积就是
$$\big\langle Jv,\ \bar y\big\rangle=\big\langle v,\ J^\top\bar y\big\rangle$$
先把记号点清.取其中一层,$x$ 是 $n$ 维、$y=f(x)$ 是 $m$ 维,于是 $J=\partial y/\partial x$ 是 $m\times n$ 的矩阵.那么:
-
$v$ 是任取输入空间($n$ 维)里的一个方向——切向量
-
$Jv$ 是把它推到输出端的结果($m$ 维),也就是 $f$ 沿 $v$ 的变化率
-
$\bar y$ 是输出端的梯度($m$ 维)
-
$J^\top\bar y$ 是把它拉回输入端的结果($n$ 维)
不过这里还能再往下说一层:$\bar y$ 本来就可以看作一个线性泛函——它吃一个输出端的扰动 $\delta y$(这里是 $Jv$ )、吐一个数($L$ 跟着变多少).不用内积的话,“$\bar y$ 与 $Jv$ 配对”的原始写法是
$$D\ell(y)\big[Jv\big]$$
读作“$y$ 沿 $Jv$ 变,$L$ 变多少”——这里一个内积都没有,只有泛函作用在向量上.上面那个内积形式,是前面那条 Riesz 把它翻译过来的结果.
不过 $x$ 和 $v$ 在这个式子里看不见,得点一下。$J=Df(x)$ 是在 $x$ 处取的,$v$ 就在 $Jv$ 里面.写全:
$$D\ell(y)\big[Jv\big]=D\ell\big(f(x)\big)\Big[Df(x)\,v\Big]=D(\ell\circ f)(x)\big[v\big]$$
中间那一步就是前面证过的那条链式法则($D(g\circ f)(x)=Dg\big(f(x)\big)\circ Df(x)$,取 $g=\ell$)——两个算子先复合,再一起作用到 $v$ 上:
$$D(\ell\circ f)(x)=\underbrace{D\ell\big(f(x)\big)}_{\text{对 }y\text{ 求导}}\circ\underbrace{Df(x)}_{\text{对 }x\text{ 求导}}$$
最右端那个东西就是 $L=\ell\circ f$ 在 $x$ 处沿 $v$ 的方向导数——“$x$ 沿 $v$ 走一步,$L$ 变多少”,说的正是它.
所以整条链在做的事,是把“对 $y$ 求导”一步步换成“对 $x$ 求导”:先复合算子(链式法则),再写成分量(矩阵乘法),最后把结果搬到 $v$ 那一侧(转置).三步各管一段,谁也不欠谁.
所以整条链是
$$\underbrace{D\ell(y)\big[Jv\big]}_{\text{泛函作用于向量}}\;=\;\underbrace{\big\langle \bar y,\ Jv\big\rangle}_{\text{Riesz 换成向量}}\;=\;\underbrace{\big\langle v,\ J^\top\bar y\big\rangle}_{\text{转置搬过去}}$$
最左边没有内积,最右边全是内积——中间那一步才是 Riesz.换句话说,内积不是这里必须的操作,它是“把泛函换成向量”之后自动长出来的样子.
这条链怎么落到具体的 $\bar x$ 上?盯最左边那个东西的意思:$D\ell(y)[Jv]$ 是“$x$ 沿 $v$ 走一步,$L$ 变多少”——它作为 $v$ 的函数,正是 $L$ 对 $x$ 的导数泛函.再由 Riesz,这个泛函必然等于 $\langle \bar x,\,v\rangle$,而那个表示向量 $\bar x$ 就是我们要的梯度.于是
$$\langle \bar x,\ v\rangle=\big\langle v,\ J^\top\bar y\big\rangle\qquad\text{(对所有 }v\text{)}$$
再次强调一遍,为什么那个表示向量恰好叫 $\bar x$ 或者 $\bar y $ ?因为按定义 $\bar x=\partial L/\partial x$ ( $y$ 同理);而“梯度”这个词本身的意思就是“把导数泛函用内积表示出来的那个向量”,(前面 Riesz 那段说的就是这个).所以不是两个东西碰巧相等,是同一个东西的两种叫法.
其实第一节已经埋下了:那里证过 $D_vf(x)=\nabla f(x)\cdot v$——方向导数就是“梯度和方向做内积”.换句话说,梯度从一开始就是那个表示向量;这里只是把同一件事在 $L=\ell\circ f$ 上又说了一遍.
两边对任意 $v$ 都相等,逐个分量比对,就读出
$$\bar x=J^\top\bar y$$
这才是 VJP 公式的来历——不是“规定反向要乘转置”,而是“把输出端的泛函搬回输入端”这件事在坐标下的必然形状.转置不是外加的动作,是搬回去的时候内积换了配对的那一方,自动掉出来的.
于是那个等式说的是:在输出端配对,和在输入端配对,得到同一个数——左边先推再配对,右边先拉再配对.
转置就是让这两条路通到同一个标量的那个东西.没有它,$Jv$ 和 $\bar y$ 配得起来,$v$ 和 $\bar y$ 却连维数都对不上.
反过来的那一路也顺带对上了:JVP 拿的是输入端的切向量 $\dot x$,吐出来的是输出端的变化 $\dot y=J\dot x$.切向量往前推,梯度往回拉——这就是两种模式的分野.
想拿到完整的 $J$ 本身,只能老老实实做 $n$ 次前向或 $m$ 次反向.这就是第三节那个 $n$ 倍差距的矩阵版本.
这也把形状摆平了:$\bar y$ 是 $m$ 维、$x$ 是 $n$ 维,外积天然是 $m\times n$,和 $W$ 同形——所以更新时能逐元素相减,不需要任何转置或广播.
反向传播跑完,每个参数上攒了一个数.优化器做的是
$$W_{ij}\leftarrow W_{ij}-\eta\left(\frac{\partial L}{\partial W}\right)_{ij}$$
逐元素减,没错.减的是梯度 $\partial L/\partial W$,不是任何一个 Jacobian.(线性层里 $\partial y/\partial x$ 恰好等于 $W$ 自己、数组大小又一样,容易看成一回事;但一个是算子、一个是梯度,只是形状撞上了.)
具体算一遍.取一层 $y=Wx$($W$ 是 $m\times n$)和平方损失 $L=\frac12\|y-t\|^2$.上游先送来
$$\bar y=\frac{\partial L}{\partial y}=y-t$$
于是两条 VJP 并行:
$$\frac{\partial L}{\partial W}=\bar y\,x^\top,\qquad \frac{\partial L}{\partial x}=W^\top\bar y$$
代一组数看看:
$$W=\begin{bmatrix}1&2\\3&4\end{bmatrix},\quad x=\begin{bmatrix}1\\0.5\end{bmatrix},\quad t=\begin{bmatrix}1\\1\end{bmatrix} \;\Longrightarrow\; y=\begin{bmatrix}2\\5\end{bmatrix},\quad \bar y=y-t=\begin{bmatrix}1\\4\end{bmatrix}$$
| 对象 | 值 | 用在哪 |
|---|---|---|
| Jacobian $\partial y/\partial x$ | $\begin{bmatrix}1&2\\3&4\end{bmatrix}$(就是 $W$) | 链式法则的中间原料 |
| 梯度 $\partial L/\partial W=\bar y\,x^\top$ | $\begin{bmatrix}1&0.5\\4&2\end{bmatrix}$ | 更新参数 |
| 梯度 $\partial L/\partial x=W^\top\bar y$ | $\begin{bmatrix}13\\18\end{bmatrix}$ | 对输入求导时才用 |
更新减的是中间那行.最后一行只在对抗样本、显著性图、隐函数求导这类场合才出场.
还有一条分工要说清:反向传播本身不做减法.它只往每个节点的累加器里加,参数一个字节都不动;减法只发生在优化器里,等所有梯度攒完之后做一次.
把它写成偏导,记号就一目了然了:
$$\underbrace{\frac{\partial L}{\partial x_j}}_{\bar x_j} \;\mathrel{+}=\; \sum_i \underbrace{\frac{\partial L}{\partial y_i}}_{\bar y_i}\, \frac{\partial y_i}{\partial x_j}$$
——上划线只是 $\partial L/\partial\cdot$ 的简写;写 $\mathrel{+}=$ 是因为一个节点可能有多条下游边,每条各送一份.减法不在这一侧:
$$\text{反向:}\quad \bar x_j \mathrel{+}= \sum_i \bar y_i\,\frac{\partial y_i}{\partial x_j} \qquad\qquad \text{更新:}\quad W_{ij}\leftarrow W_{ij}-\eta\,\bar W_{ij}$$
分开不是实现细节,它换来几件事:能在更新前先跑一遍梯度校验、能先做梯度裁剪、能把几个 batch 的反向叠起来再减一次(梯度累积)、能拿同一批梯度喂不同优化器做对比.反向后直接减,“先看再减”就没有位置了.
缩并是什么
上一段说,AD 系统只做两件事:把 $J$ 乘到一个向量上,或者把 $J^\top$ 乘到一个向量上.这个动作有名字,叫缩并.
把两个张量里配对的一对指标求和,配掉之后这对指标就消失了.
$$y_i = \sum_j A_{ij}\,x_j$$
$j$ 在 $A$ 和 $x$ 里各出现一次,求和之后它就不见了——这就是一次缩并.Einstein 求和约定把 $\sum_j$ 直接省掉,写成 $y_i = A_{ij}x_j$:一个指标在一项里出现两次,就自动对它求和.
阶数的账很好算:
$$\text{结果阶数} = \text{各因子阶数之和} – 2\times(\text{缩并的对数})$$
| 运算 | 阶数变化 | 缩并对数 |
|---|---|---|
| 内积 $\sum_i x_i y_i$ | 1 + 1 → 0 | 1 |
| 矩阵乘向量 $A_{ij}x_j$ | 2 + 1 → 1 | 1 |
| 矩阵乘矩阵 $A_{ij}B_{jk}$ | 2 + 2 → 2 | 1 |
| 双缩并 $\sum_{ij} A_{ij}B_{ij}$ | 2 + 2 → 0 | 2 |
| 标量乘标量 | 0 + 0 → 0 | 0 |
最后一行是关键:标量图上那些“乘一个数再累加”的局部规则,是缩并 0 对的特例——不是另一种操作,是同一个操作在零指标下的退化.
同一个数组,缩并不同的指标
回到导数.反向传播要用的那个数组 $\partial y_i/\partial x_j$ 是固定的,两种模式的区别只在于跟谁缩并:
-
前向:$\dot y_i = \sum_j \dfrac{\partial y_i}{\partial x_j}\,\dot x_j$ —— 和切向量 $\dot x$ 缩并,配掉输入指标
-
反向:$\bar x_j = \sum_i \bar y_i\,\dfrac{\partial y_i}{\partial x_j}$ —— 和行向量 $\bar y$ 缩并,配掉输出指标
同一个数组,两组指标各被用掉一次.这也解释了为什么两种模式的单趟代价相同、只是“方向”不同——它们做的是同一件事,缩并的是不同那一头.
七、为什么必须反着走
标量情形下顺序是不可见的
标量的链式法则是
$$\frac{\mathrm{d}L}{\mathrm{d}x} = \frac{\mathrm{d}L}{\mathrm{d}y}\cdot\frac{\mathrm{d}y}{\mathrm{d}x}$$
这是实数乘法的乘积.$\mathbb{R}$ 在乘法下可交换,所以这些因子按什么顺序乘都一样.标量的“转置”又是空操作.所以“反向”这件事在标量世界完全不可见——你手算一个标量图的前向和反向,会发现在每个节点上做的算术逐字相同.
张量情形:两头一夹,顺序就锁死了
张量这里,链式法则给出的不再是“一串数相乘”,而是“一串矩阵相乘”:
$$J=J_LJ_{L-1}\cdots J_1$$
这个因子的次序动不了.它由复合的顺序决定,而矩阵乘法不可交换($AB\ne BA$,在两边都有定义时),所以没法靠交换律把它重排成别的样子.
(顺带修一个常见说法:把“矩阵乘法”直接说成非交换幺半群,只对同阶方阵成立——两个 $2\times3$ 的矩阵根本乘不起来,可复合性先挡在前面.)
另一边,反向传播从输出端拿到余向量 $\bar y^\top$.先把它摆到该在的位置:
$$\nabla_xL=J^\top\bar y\quad\Longrightarrow\quad(\nabla_xL)^\top=\bar y^\top J=\bar y^\top J_LJ_{L-1}\cdots J_1$$
(这一行哪来的?把链式法则逐项写开就知道.$\nabla_xL$ 的第 $i$ 个分量是
$$\frac{\partial L}{\partial x_i}=\sum_j\frac{\partial L}{\partial y_j}\frac{\partial y_j}{\partial x_i}=\sum_j\bar y_j\,J_{ji}=(J^\top\bar y)_i$$
所以那个转置不是额外加的,是从求和里冒出来的:它把“$J$ 的第 $i$ 列”和 $\bar y$ 配成了一次内积.)
形状检查:$\bar y^\top$ 是 $1\times n_L$,每个 $J_i$ 是 $n_i\times n_{i-1}$,一路乘下来是 $1\times n_0$——正好是输入梯度的形状.
现在看 $\bar y^\top$ 待在哪儿:乘积的最左端.而挨着它的那个因子,是 $J_L$——最后一层的 Jacobian.
两头一夹,顺序只剩一种:$\bar y^\top$ 先乘 $J_L$,再乘 $J_{L-1}$,……最后乘 $J_1$.从最后一层开始,一层层往前推——这就是“反向”的全部来历.
(如果矩阵乘法可交换、而且都是同阶方阵,你就能把 $J_1$ 挪到 $\bar y^\top$ 旁边,从第一层开始算,结果一样.所以“非交换”在这里不是废话:它保证了没有第二条路.至于加括号的方式——只影响代价不影响结果,那是第三节讲过的前向与反向之分.)
合起来看:路径求和
把第二节的扇出和上一小节的乘积放在一起,能写成一个统一的形式.对一张 DAG,输出对输入的导数等于所有从输入到输出的路径上,局部 Jacobian 乘积之和:
$$\frac{\partial L}{\partial x} = \sum_{\text{路径 } p:\, x \to L}\ \prod_{e \in p} J_e$$
乘积需要可复合性,求和来自扇出.反向传播做的事情就是不去枚举这些路径,直接用动态规划把这个和求出来——路径条数随图的大小指数增长,但按逆拓扑序走一趟就能把和累加完.
这也说明了那个 $\mathrel{+}=$ 里的加号是结构性的:它就是上面的 $\sum$.
总结
设 $f = f_L \circ \cdots \circ f_1$,链式法则给出总 Jacobian $J = J_L\cdots J_1$.反向传播算的是 $\bar y^\top J$,从最左边开始乘;前向模式算的是 $Jv$,从最右边开始乘.这是同一个矩阵乘积的两种结合顺序.
标量情形下每个 $J_i$ 都是 $1\times1$ 的,转置是空操作,$\mathbb{R}$ 的乘法又可交换——这一整层结构被压扁成了一个数字,所以看不见.
八、形状是从哪来的:Fréchet 导数
这一节是进阶内容,可以跳过.前面七节已经够回答“怎么算”和“为什么这么算”;这一节补的是最后一个为什么——导数的形状为什么必然如此.它会用到一点泛函分析的词汇(赋范空间、线性泛函),不熟也不影响读其余部分.
回到第六节留下的那个问题:为什么导数的元素个数恰好是“输入大小 × 输出大小”,阶数恰好是 $p+q$?
这需要把“导数”这个词的定义拿回来.
一维:两种等价的写法
在 $\mathbb{R}\to\mathbb{R}$ 上,导数有两种写法,课本里都出现过.
差商形式——导数是差商的极限:
$$f'(x)=\lim_{h\to 0}\frac{f(x+h)-f(x)}{h}$$
余项形式——导数是那个让线性逼近成立的系数:
$$f(x+h)=f(x)+f'(x)h+r(h),\qquad \lim_{h\to 0}\frac{r(h)}{|h|}=0$$
也就是常写的紧凑形式
$$f(x+h)=f(x)+f'(x)h+o(|h|)$$
两者说的是同一件事.余项式两边减去 $f(x)$、除以 $h$,就得到差商式;反过来,把差商式乘以 $h$ 再移项,就得到 $r(h)=o(|h|)$.在一维,它们可以互相翻译.
高维:只剩余项形式
差商式一到 $\mathbb{R}^n$ 就坏了——分母是 $h$,而 $h$ 一旦是向量,除法就没有定义.这一条就把它废掉了.
能救回来一半的是“沿每个方向取差商”,也就是方向导数:
$$D_vf(x)=\lim_{t\to 0}\frac{f(x+tv)-f(x)}{t}$$
但它给出的是 Gâteaux 导数,不是 Fréchet 导数,而且两者真的不同:
-
Gâteaux 只要求沿每条直线逼近得好
-
Fréchet 要求沿所有路径逼近得好——$h$ 可以走曲线趋于 $0$
差别不是抬杠.令
$$f(x,y)=\frac{x^3y}{x^6+y^2}\quad\big((x,y)\ne(0,0)\big),\qquad f(0,0)=0$$
沿任意方向 $(a,b)$ 取差商:
$$\frac{f(ta,tb)}{t}=\frac{t\,a^3b}{t^4a^6+b^2}\xrightarrow{\ t\to 0\ }0$$
所有方向导数都是 $0$,Gâteaux 导数存在,而且还是线性的(零算子).但沿曲线 $h=(t,t^3)$ 趋于原点:
$$\frac{\big|f(t,t^3)\big|}{\big\|(t,t^3)\big\|}=\frac{1/2}{\sqrt{t^2+t^6}}\longrightarrow\infty$$
余项连有界都做不到,更谈不上 $o(\|h\|)$.Fréchet 导数不存在.
所以下面这个定义不是“差商形式在高维的翻译”,而是唯一能在高维站住的那个版本.
定义
设 $X,Y$ 是赋范空间,$U\subseteq X$ 是开集,$f:U\to Y$.称 $f$ 在 $x\in U$ 处 Fréchet 可微,如果存在一个有界线性算子 $A:X\to Y$ 使得
$$\lim_{\|h\|\to 0}\frac{\big\|f(x+h)-f(x)-Ah\big\|_Y}{\|h\|_X}=0$$
这样的 $A$ 若存在则唯一,记作 $Df(x)$.
(有限维时“有界”两个字可以不管——有限维赋范空间之间的线性算子全都自动有界.)
三条从定义直接读出来的事,后面的内容全建在它们上面.
① 导数是线性算子,不是数.定义里“线性算子”这四个字就是全部内容.整个自动微分的理论,说到底就是在回答三个问题:这个算子怎么表示、怎么算出来、怎么和其他算子复合.
② 一维是退化情形.当 $X=Y=\mathbb{R}$ 时,有界线性算子只有 $Ah=ah$ 这一种($a\in\mathbb{R}$),算子和数一一对应.这是唯一一个能把导数塞进一个数里的情形,而我们从小被教的恰好就是它.“导数是数”是退化印象,不是通例.
③ 链式法则就是复合.
$$D(g\circ f)(x)=Dg\big(f(x)\big)\circ Df(x)$$
右边是算子的复合,不是数的乘法.这一条后面会反复回来——复合不交换、转置反变、所以反向传播必须逆序,根源都在这里.
有限维下:线性算子就是高阶张量
现在做关键的一步:有限维时,从 $X$ 到 $Y$ 的所有线性算子本身也构成一个向量空间,记作 $L(X,Y)$,并且
$$\dim L(X,Y)=\dim X\cdot\dim Y$$
所以 $Df(x)$ 无非是 $L(X,Y)$ 里的一个元素——取定基之后,它就是一组 $\dim X\cdot\dim Y$ 个数.
剩下的问题只是“这组数怎么排指标”.设 $X$ 的坐标带 $p$ 个指标(于是 $\dim X=n_1\cdots n_p$),$Y$ 的坐标带 $q$ 个指标.$Df(x)$ 要同时记住“输出的哪一个分量”和“输入的哪一个分量”,所以它的坐标自然带 $p+q$ 个指标:
$$\big(Df(x)\big)_{i_1\cdots i_q\,j_1\cdots j_p}=\frac{\partial y_{i_1\cdots i_q}}{\partial x_{j_1\cdots j_p}}$$
前 $q$ 个标输出,后 $p$ 个标输入.阶数 $p+q$ 是这么来的——它不是约定,是“线性算子的坐标需要两组指标”这件事的写法.元素个数则是 $\dim X\cdot\dim Y$,也就是输入数组的大小乘以输出数组的大小.
| $f$ | $p$ | $q$ | 阶数 | 导数长什么样 | 元素个数 |
|---|---|---|---|---|---|
| $f:\mathbb{R}\to\mathbb{R}$ | 0 | 0 | 0 | 一个数 | 1 |
| $L:\mathbb{R}^n\to\mathbb{R}$(损失) | 1 | 0 | 1 | 行向量,$\partial L/\partial w_i$ | $n$ |
| $f:\mathbb{R}\to\mathbb{R}^m$ | 0 | 1 | 1 | 向量,$\mathrm{d}y_i/\mathrm{d}t$ | $m$ |
| $f:\mathbb{R}^n\to\mathbb{R}^m$ | 1 | 1 | 2 | 矩阵,$\partial y_i/\partial x_j$ | $mn$ |
| $Y=AB$,$A$ 是 $m\times k$ | 2 | 2 | 4 | 四阶张量 | $m^2nk$ |
盯一下最后一行:$\partial Y/\partial A$ 有 $m^2nk$ 个元素,比 $A$ 自己($mk$ 个)大了 $mn$ 倍.这个数组根本不是拿来写下来的——它是拿来“作用”的.
九、收束
-
梯度是“同样步长下降最多”的方向,这个结论只在局部、一阶、且指定了范数的意义下成立.
-
自动微分 = 计算图 + 每条边一条局部规则 + 逆拓扑序遍历.逆拓扑序由 DFS 后序反转得到,也可以用 id 单调性绕开.之所以一趟能算出所有参数的梯度,是因为中间保存的 $\partial L/\partial v$ 与求导对象无关.
-
从标量到张量是算子粒度的提升,代价是局部导数从数变成 Jacobian 矩阵、反向规则必须手推.工程上说“优化算子”,指的其实是粒度设计、编译期融合、手写融合算子三件不同的事,数学代价各不相同.
最后说一句
这套东西是我手算小计算图的时候才想明白的.当时把同一个函数的前向和反向都手推了一遍,发现逐项算术完全一样,一度以为“反向模式”是个没有实质内容的说法.后来才意识到标量图上这个区别本来就不可见,因为它被压扁成了趟数.
附:完整可运行版本
把前面几节用到的代码拼成一个文件,末尾加一层中心差分校验.不用装任何东西,python3 graph_demo.py 直接跑.
#!/usr/bin/env python3
"""《反向传播》一文的完整示例:一个能跑的最小标量自动微分.

对应正文的表达式
    L = (sigma(w1*x1 + w2*x2 + b) - y)^2
和第二节那张 13 个节点的表.

运行:python3 graph_demo.py
"""
import math


class Node:
    """计算图上的一个顶点.叶子没有 inputs;操作节点记下输入,并自带局部反向规则."""

    _next_id = 0

    def __init__(self, val, op="leaf", inputs=(), backward=None):
        self.id = Node._next_id            # 编号只增,且只引用已有节点
        Node._next_id += 1
        self.val = val                     # 前向数值
        self.op = op                       # 算子,决定反向用哪条局部规则
        self.inputs = inputs               # 输入节点的编号
        self.grad = 0.0                    # 反向时在这里累加
        self._backward = backward or (lambda: None)
        # 想看建图过程,把下面这行放开:
        # print(f"新建 #{self.id}  op={op}  值={val:.4f}  输入={[u.id for u in inputs]}")

    def __mul__(self, other):
        out = Node(self.val * other.val, "*", (self, other))

        def bw():                          # 局部规则:按另一个乘数分配上游梯度
            self.grad += out.grad * other.val
            other.grad += out.grad * self.val

        out._backward = bw
        return out

    def __add__(self, other):
        out = Node(self.val + other.val, "+", (self, other))

        def bw():
            self.grad += out.grad
            other.grad += out.grad

        out._backward = bw
        return out

    def __sub__(self, other):
        out = Node(self.val - other.val, "-", (self, other))

        def bw():
            self.grad += out.grad
            other.grad -= out.grad

        out._backward = bw
        return out


def sigmoid(z):
    s = 1.0 / (1.0 + math.exp(-z.val))
    out = Node(s, "sigma", (z,))

    def bw():
        z.grad += out.grad * s * (1.0 - s)

    out._backward = bw
    return out


def topo_order(root):
    """DFS 后序.反转它才是反向传播要的逆拓扑序."""
    order, seen = [], set()

    def visit(v):
        if id(v) in seen:                  # 不标记,扇出节点会被重复展开
            return
        seen.add(id(v))
        for u in v.inputs:
            visit(u)                       # 先把所有前驱走完
        order.append(v)                    # 再把自己记下来

    visit(root)
    return order


def backward(root):
    root.grad = 1.0                        # 播种子:dL/dL = 1
    for v in reversed(topo_order(root)):   # 逆拓扑序
        v._backward()


def build(w1v, x1v, w2v, x2v, bv, yv):
    Node._next_id = 0
    w1, x1, w2, x2, b, y = (Node(v) for v in (w1v, x1v, w2v, x2v, bv, yv))
    d = sigmoid(w1 * x1 + w2 * x2 + b) - y
    L = d * d                              # 同一个节点用了两次
    return L, (w1, x1, w2, x2, b, y)


if __name__ == "__main__":
    BASE = (0.50, 1.20, -0.30, 0.80, 0.10, 1.00)
    NAMES = ("w1", "x1", "w2", "x2", "b", "y")

    L, leaves = build(*BASE)

    print("=== 建出来的图 ===")
    print(f"{'节点':>4}  {'算子':<6} {'值':>9}   输入")
    for v in topo_order(L):
        ins = ", ".join(f"#{u.id}" for u in v.inputs) or "—"
        print(f"{v.id:>4}  {v.op:<6} {v.val:>9.4f}   {ins}")

    backward(L)
    print(f"\n=== 梯度(中心差分校验)===")
    worst = 0.0
    for i, name in enumerate(NAMES):
        def f(t, i=i):
            args = list(BASE)
            args[i] = t
            return build(*args)[0].val

        ng = (f(BASE[i] + 1e-6) - f(BASE[i] - 1e-6)) / 2e-6
        rel = abs(leaves[i].grad - ng) / max(abs(ng), 1e-12)
        worst = max(worst, rel)
        print(f"  dL/d{name:<3} = {leaves[i].grad: .8f}"
              f"   差分 {ng: .8f}   相对误差 {rel:.1e}")
    print(f"\n最差相对误差 {worst:.1e}")
输出:
=== 建出来的图 ===
  节点  算子             值   输入
   0  leaf      0.5000   —
   1  leaf      1.2000   —
   6  *         0.6000   #0, #1
   2  leaf     -0.3000   —
   3  leaf      0.8000   —
   7  *        -0.2400   #2, #3
   8  +         0.3600   #6, #7
   4  leaf      0.1000   —
   9  +         0.4600   #8, #4
  10  sigma     0.6130   #9
   5  leaf      1.0000   —
  11  -        -0.3870   #10, #5
  12  *         0.1498   #11, #11

=== 梯度(中心差分校验)===
  dL/dw1  = -0.22032911   差分 -0.22032911   相对误差 1.3e-10
  dL/dx1  = -0.09180379   差分 -0.09180379   相对误差 8.4e-11
  dL/dw2  = -0.14688607   差分 -0.14688607   相对误差 5.0e-10
  dL/dx2  =  0.05508228   差分  0.05508228   相对误差 5.7e-10
  dL/db   = -0.18360759   差分 -0.18360759   相对误差 8.4e-11
  dL/dy   =  0.77397165   差分  0.77397165   相对误差 2.5e-11

最差相对误差 5.7e-10
最差相对误差 5.7e-10.任何一条局部规则写错,这个数字立刻会跳起来.梯度校验是写自动微分时唯一靠得住的东西——不要相信自己推的公式,包括本文里的这几条.
(co-work with deepseek-v4-1-flash)